NeedSift 的排名算法内部:决定每个评分的公式
NeedSift 的精确排名公式、信号权重、新鲜度窗口、投票保护机制、网站质量检查以及每个产品评分背后的逻辑。
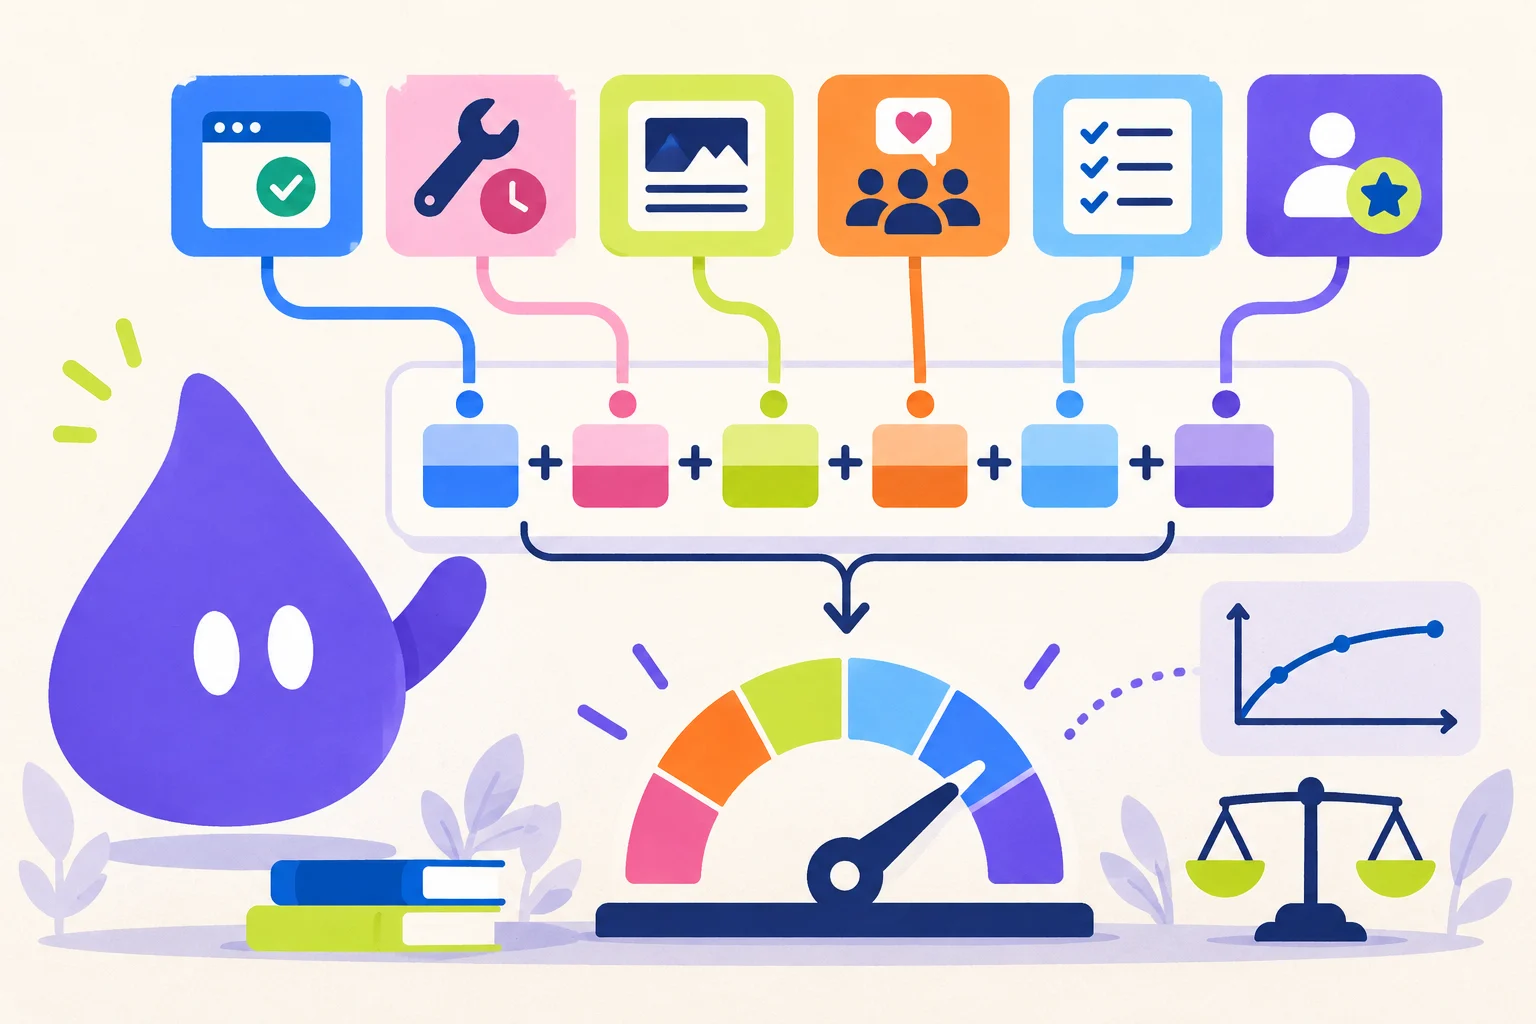
一个评分,六个独立的信号
NeedSift 的目录并非按照原始的“向上投票数”、“页面数量”或产品提交日期进行排序。 后端计算从 0 到 100 的评分,然后再返回目录。 相同的存储评分被所有访客使用,因此卡片不会在加载后改变顺序。
该公式结合了可靠性、近期维护、网站质量、公众活动、列表完整性和经过认证的社区支持。 只有在受控的社区组件内,一个较大的受众才能发挥作用。 一个小产品可以通过保持可用、及时交付、清晰地解释自身,并保持可信的公开证据,从而获得高分。
本页介绍公式的第 2 版,自 2026 年 9 月 25 日起生效。算法的每一次改动都列在文末的版本历史中,方便开发者了解改了什么、为什么改。
Score = min(100, 0.20U + 0.25M + 0.15Q + 0.10S + C + V)U、M、Q 和 S 均在 0 到 100 之间进行标准化。 C 和 V 直接贡献 0 到 15 分。 总分四舍五入到两位小数,并限制在 100。- Uptime (可用性) U:最高 20 分。
- Maintenance (维护) M:最高 25 分。
- Site quality (网站质量) Q:最高 15 分。
- Social activity (社交活动) S:最高 10 分。
- Listing completeness (列表完整性) C:最高 15 分。
- 社区支持 V:最多 15 分(投票 12 分,讨论 3 分)。
可用性奖励实际可用的产品。
可用性基于过去 30 天内每日的观察。 70% 的评分来自成功的检查数量。 其余的 30% 来自成功的检查的平均响应时间,而不是最快的响应时间。
响应时间在 800 毫秒或以下,获得 30 分的“速度”奖励;在 2 秒或以下,获得 22 分;在 5 秒或以下,获得 12 分;响应时间较慢的成功响应获得 4 分。 停用的域名无论其 HTTP 状态如何,都获得 0 分。
U = min(100, 70 × available_days / observed_days + speed_bonus)速度奖励:当中位数 ≤ 800 毫秒时,为 30;当 ≤ 2,000 毫秒时,为 22;当 ≤ 5,000 毫秒时,为 12;否则为 4。维护使用最新的、经过验证的日期。
一个产品不应该每周都需要重新设计其主页才能保持活力。NeedSift 从五个独立来源获取最新的、可信的日期:有意义的主页更改、产品的自身更新日志或博客、App Store 或 Google Play 发布、新发布的 sitemap URL,或公开的 GitHub 或 Telegram 更新。
第一次扫描会创建基准,并且不会假定所有已存在的都是新的更新。产品也会从其 NeedSift 创建日期开始获得 7 天的发布窗口。在此之后,它必须展示活动。Store、sitemap 和社交子评分仍然可见,以便进行解释,但它们的最新验证日期会流向维护,从而避免对同一发布进行多次奖励。
M(age) = 100 ≤7d · 85 ≤30d · 60 ≤90d · 35 ≤180d · 10 otherwise年龄的测量基于最新的验证活动日期,或者,如果尚未观察到任何活动,则基于产品的创建日期。网站质量衡量的是信任,而不是网站大小。
质量分析器可以为小型独立产品提供与大型网站相同的 100 分。它会寻找有用的元数据、移动支持、Favicon 和 canonical 或语言信号;法律和联系方式;定价、文档、下载或注册路径;更新日志;足够的真实产品内容;以及证明页面实际描述所列产品的证据。
元数据可贡献高达 40 个原始质量分数,信任度和产品结构为 36,身份信息为 12,以及内容为 12。如果页面包含 40 个字以下的内容,则结果会被减半。停用或出售的域名将获得 0 分。NeedSift最多检查 8 张主页图片:如果至少有 3 张图片被采样,则损坏的图片会根据其比例,分别扣除 10、20 或 30 分。因此,即使产品的元数据正确,但如果页面本身存在视觉问题,也无法获得完整的质量评分。
Q = clamp₀₋₁₀₀(metadata + trust + identity + substance − image_penalty)最终排名基于此经过规范化的质量结果的 15%。页面数量和营销流量不是输入项。公开活动和个人资料完整性
对于公开活动,每个可访问的 GitHub 或 Telegram 个人资料会贡献 15 个原始分数,最高为 45 分。新发布的帖子或提交会将社交得分设置为 100。否则,在 7、30 或 90 天内发生的活动会分别贡献 55、40 或 20 分。X 链接如果没有可靠的公开接口,则不会被抓取。如果产品没有可追踪的公开个人资料,社交得分将保持中性,即为 30,而不是成为惩罚。
完整性是有限的。一个标志贡献 3 分。截图贡献 1.5 分,最多 4 分。一段描述贡献 2 分,从 120 个字符开始,以及 300 个字符贡献 4 分。一个标语贡献 1 分;有用的链接覆盖贡献最多 2 分;一个类别贡献 1 分。添加 10 个重复链接或数百张截图并不能提高结果。
S = min(100, 15 × reachable_profiles + freshness_bonus); S = 30 when untracked新鲜度奖励:≤7 天为 55 分,≤30 天为 40 分,≤90 天为 20 分;新观察到的活动会使 S = 100。C = logo(3) + screenshots(max 4) + description(max 4) + tagline(1) + links(max 2) + category(1)完整度自然限制在 15 分,并奖励有用的证据,而不是用户数量。投票和讨论有帮助,但买不下整个目录
NeedSift 使用正面投票,而不是正面和负面评分等级。因此,威尔逊区间不是合适的模型,而 IMDb 风格的贝叶斯平均值需要一个有意义的评分值,以便将评分缩小到目录。相反,NeedSift 使用对数曲线:早期的真实支持很重要,回报迅速下降,社区影响力在 15 分处停止。
曲线的顶端不是一个固定票数。投票满分位于所有已批准产品加权票数的第 90 百分位,且不低于 10。简单来说,当一个产品获得的支持超过目录中十分之九的产品时,就能拿到全部 12 分投票分。之所以用百分位而不是最大值,是因为一个被刷票的条目可以拉高最大值,却无法移动第 90 百分位。下限可以防止一个年轻的目录因为一票就给出满分。该标尺会在每次每日扫描时重新计算。
投票需要身份验证,并且一个账户只能对一个产品进行一次投票。如果账户在投票时小于 24 小时,该投票将具有 0.25 的权重。一个已建立的账户将获得 1。这并不能解决所有协调的活动,但它使在发布当天创建的临时账户的有效性降低了 4 倍,并为异常审查提供了清晰的基础。
W = Σ vote_weight; vote_weight = 0.25 if account_age < 24h, otherwise 1账户的年龄在投票时进行测量,因此稍后等待不会使可疑的、新鲜的投票获得升级。V_votes = 12 × min(1, ln(1 + W) / ln(1 + W₉₀)); W₉₀ = max(10, P90 of W across the catalog)在最低标尺下,一张完整的票约为 3.47 分,三张约为 6.94 分,十张达到 12 分上限。随着目录增长,W₉₀ 也会随之增长,同样的票数按比例价值更低。V = V_votes + V_discussion讨论部分在下一节说明,最多增加 3 分,因此 V 永远不会超过 15。讨论只占一点分量
被人讨论的产品,通常也是有人在用的产品。从第 2 版起,社区部分也会统计产品下方的讨论。计数单位是人而不是消息:每位不同的评论者只计一次,无论写了多少条评论,因此两个账号之间的长篇争论不会看起来像一群人。
只有通过审核的评论才计入。产品作者本人的评论不计入:回答问题很受欢迎,但不能借此提高自己的分数。首次评论时账号注册不足二十四小时的评论者按 0.25 计算,与新账号投票的折扣相同。被隐藏、被拒绝和被删除的评论计为零。
这部分权重刻意设得很小。账号很便宜,评论文字也很容易生成,所以讨论只用于区分相近的产品,而不是一个杠杆。它采用与投票相同的、相对于目录的标尺,下限为五位评论者。
D = Σ commenter_weight; commenter_weight = 0.25 if account_age < 24h at first comment, otherwise 1每位至少有一条已批准评论的不同评论者计一条,不包括产品作者。V_discussion = 3 × min(1, ln(1 + D) / ln(1 + D₉₀)); D₉₀ = max(5, P90 of D across the catalog)在最低标尺下,一位老账号评论者约为 1.16 分,三位约为 2.32 分,五位达到 3 分上限。一个示例
考虑一款拥有完美运行时间、过去三十天内的活跃度、网站质量评分 80、社交评分 70、十三个完整性点以及三个已确认投票的产品。该产品获得 20 个运行时间点、21.25 个维护点、12 个质量点、7 个社交点、13 个完整性点以及 6.94 个社区点。
其最终得分是 80.19。 更多的投票仍然有帮助,但即使达到上限也只会增加 8.06 个点。 更有利的方式是改进产品本身:修复损坏的媒体、保持网站可用、发布真正的版本、完成列表,或添加有用的更新日志。
20 + 21.25 + 12 + 7 + 13 + 6.94 = 80.19示例输入:U=100, M=85, Q=80, S=70, C=13, W=3, D=0, W₉₀=10.与启动推荐的区别
像 Hacker News 这样的时间衰减推荐,旨在快速呈现最新的内容:随着时间的推移,受欢迎程度会逐渐降低。 NeedSift 的目标不同。 一个有用的产品不应该仅仅因为发布几个月后就消失,但如果每个公开信息都变得过时,它应该逐渐减少维护信用。 逐步的维护窗口为新产品提供公平的起点,并允许较旧的产品立即恢复,通过发布可验证的工作。
关于开源项目放弃的研究也表明,仅仅依靠一个最新的提交日期不足以描述项目的生存情况。 NeedSift 不宣称任何一个公开的跟踪记录都证明了产品的健康状况。 它结合了独立的路径,并有意限制每个组件。 即使公式会演变,但变化也应该保持可解释性和可测试性。
评分是可查看的,而不是一个“黑盒子”
每个组件都由后端存储,并在“为什么这个评分”区块中显示在产品页面上。 开发者可以查看可用性、维护、网站质量、社交活动、完整性以及社区贡献,而不是猜测竞争对手为何超越他们。 目录排序仅在后端重新计算评分后才会改变;在某人阅读时,不会在浏览器中重新排序。
透明并不意味着永久发布所有反滥用阈值。 意味着发布正常的规则,将测量到的事实与编辑决策分开,并解释实质性的变更。 目标不是一个数学上完美的质量定义。 这是一个排名,其激励机制指向可靠的产品、诚实的维护以及有用的公共工作。
版本历史
随着 NeedSift 不断了解持续维护的产品与被放弃的产品之间的差别,公式也会随之调整。下面每个版本都列出了改动内容和原因。改动上线后,分数会在下一次每日扫描时重新计算。
- v2 — 2026 年 9 月 25 日。社区支持现在由投票(最多 12 分)和讨论(最多 3 分)组成:统计拥有已批准评论的不同评论者,不包括产品作者,并对新账号打折。满分不再是固定票数,而是位于目录的第 90 百分位,下限为 10 票和 5 位评论者,让标尺随 NeedSift 一起成长。
- v1 — 2026 年 9 月 24 日。第一个公开公式:可用性 20、维护 25、网站质量 15、社交活跃度 10、完整度 15,以及固定对数曲线上的投票 15,V = min(15, 5 × ln(1 + W)),新账号投票的权重为 0.25。