Dentro do Algoritmo de Classificação da NeedSift: A Fórmula por Trás de Cada Nota
A fórmula exata de classificação da NeedSift, pesos de sinais, janelas de atualização, salvaguardas de voto, verificações de qualidade do site e a justificativa por trás de cada nota de produto.
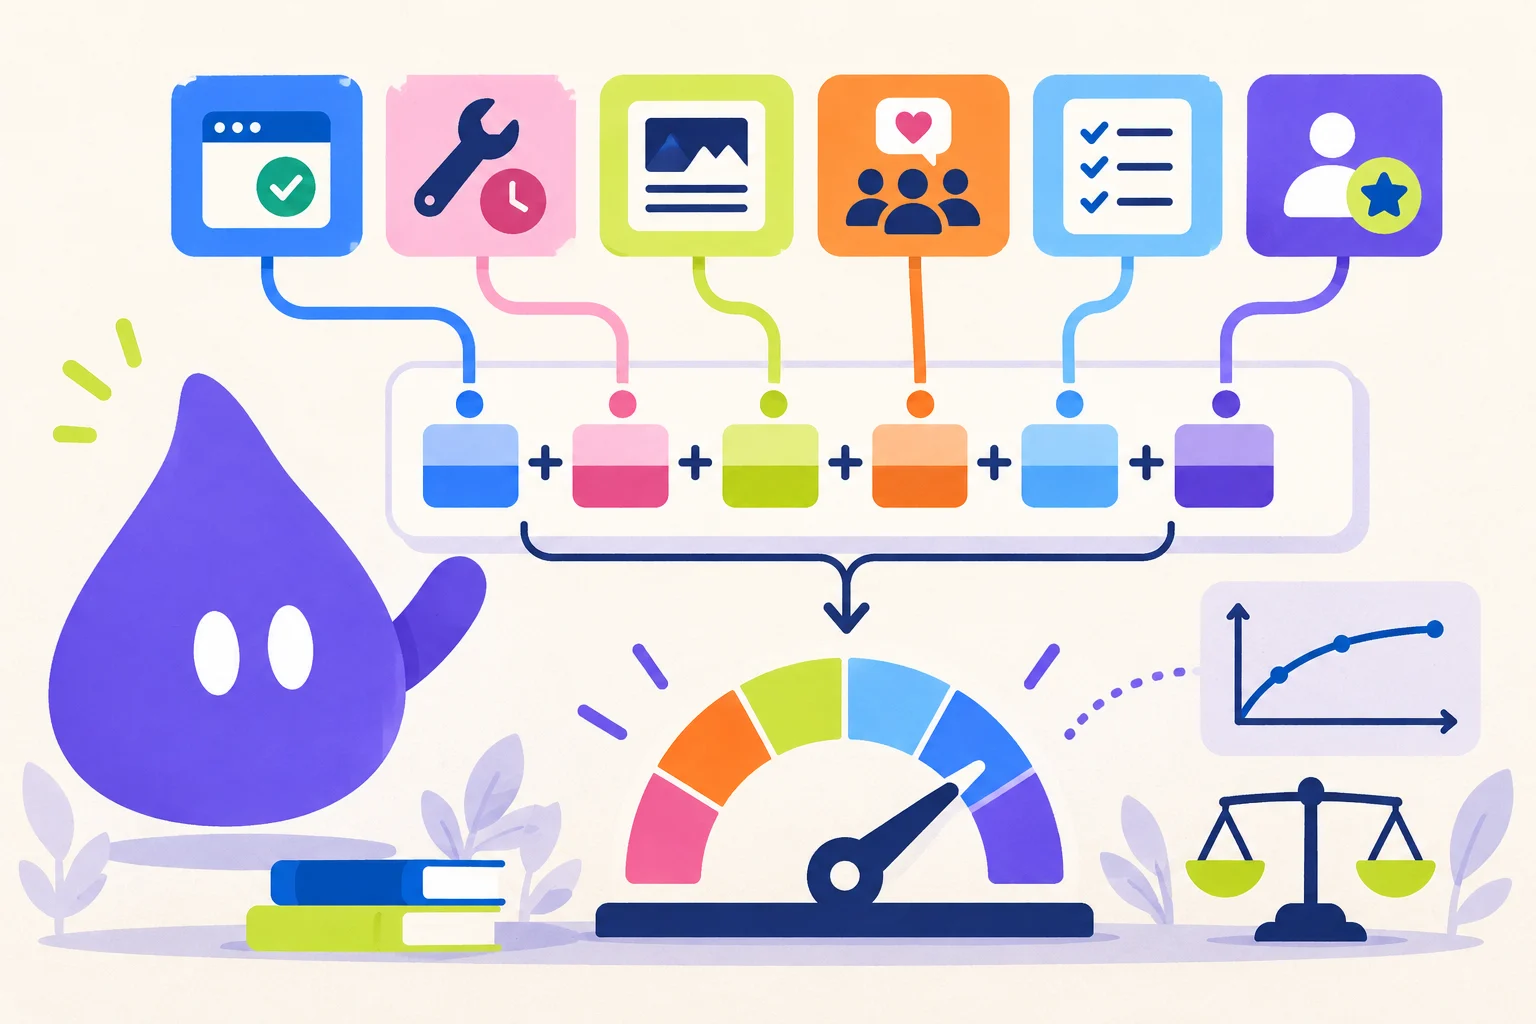
Uma nota, seis sinais independentes
O catálogo da NeedSift não é ordenado por votos brutos, número de páginas ou a data em que um produto foi submetido. O backend calcula uma nota de zero a cem antes de retornar o catálogo. A mesma nota armazenada é usada por todos os visitantes, para que os cartões não mudem de ordem após a atualização.
A fórmula combina confiabilidade, manutenção recente, qualidade do site, atividade pública, completude da lista e suporte da comunidade autenticado. Um grande público ajuda apenas dentro do componente da comunidade restrito. Um pequeno produto pode alcançar o topo permanecendo disponível, entregando, explicando-se de forma clara e mantendo evidências públicas credíveis.
Esta página descreve a versão 2 da fórmula, em vigor desde 25 de setembro de 2026. Cada mudança no algoritmo aparece no histórico de versões no fim do artigo, para que os criadores vejam o que mudou e porquê.
Score = min(100, 0.20U + 0.25M + 0.15Q + 0.10S + C + V)U, M, Q e S são normalizados de 0 a 100. C e V contribuem diretamente de 0 a 15 pontos cada. O total é arredondado para duas casas decimais e limitado a 100.- Tempo de atividade: até 20 pontos.
- Manutenção: até 25 pontos.
- Qualidade do site: até 15 pontos.
- Atividade social: até 10 pontos.
- Completude da lista: até 15 pontos.
- Apoio da comunidade V: até 15 pontos (12 por votos, 3 por discussão).
O tempo de atividade recompensa um produto que realmente funciona.
O tempo de atividade é baseado em observações diárias da janela dos últimos 30 dias. 70% do componente vem da porcentagem de verificações bem-sucedidas. Os 30% restantes vêm do tempo médio de resposta das verificações bem-sucedidas, e não da resposta mais rápida.
Uma resposta de 800 milissegundos ou menos recebe um bônus de velocidade de 30 pontos; de 2 segundos ou menos, recebe 22; de 5 segundos ou menos, recebe 12; uma resposta bem-sucedida mais lenta recebe 4. Um domínio em espera recebe zero, independentemente do seu status HTTP.
U = min(100, 70 × available_days / observed_days + speed_bonus)speed_bonus = 30 quando a mediana ≤ 800 ms; 22 quando ≤ 2.000 ms; 12 quando ≤ 5.000 ms; caso contrário, 4.A manutenção utiliza a data mais recente e verificada.
Um produto não deve precisar reescrever sua página inicial semanalmente para parecer atualizado. O NeedSift obtém a data mais recente e confiável de cinco fontes independentes: uma mudança significativa na página inicial, o próprio changelog ou blog do produto, uma versão na App Store ou Google Play, um URL de sitemap recém-publicado ou uma atualização pública no GitHub ou Telegram.
A primeira varredura cria uma linha de base e não finge que tudo o que já está presente é uma nova atualização. Um produto também recebe uma janela de lançamento de sete dias a partir da sua criação NeedSift. Após esse período, ele deve demonstrar atividade. As pontuações de sub-nível para App Store, sitemap e redes sociais permanecem visíveis para explicação, mas suas datas mais recentes e verificadas fluem para a manutenção, para que o total não recompense a mesma versão várias vezes.
M(age) = 100 ≤7d · 85 ≤30d · 60 ≤90d · 35 ≤180d · 10 otherwiseA idade é medida a partir da data mais recente de atividade verificada ou, quando nenhuma atividade foi observada, a data de criação do produto.A qualidade do site mede a confiança, não o tamanho do site.
O analisador de qualidade pode dar a um pequeno produto independente uma pontuação de 100, igual a um grande site. Ele procura metadados úteis, suporte móvel, um favicon e um sinal canônico ou de idioma; rotas legais e de contato; caminhos de preços, documentação, download ou inscrição; um changelog; conteúdo real do produto suficiente e evidências de que a página realmente descreve o produto listado.
Os metadados contribuem com até 40 pontos brutos de qualidade, confiança e estrutura do produto 36, identidade 12 e substância 12. Uma página com menos de quarenta palavras tem seu resultado reduzido pela metade. Um domínio estacionado ou à venda recebe zero. O NeedSift verifica no máximo oito imagens da página inicial: quando pelo menos três são amostradas, imagens quebradas subtraem 10, 20 ou 30 pontos, dependendo de sua proporção. É por isso que uma página de produto visualmente quebrada não pode receber crédito total de qualidade, simplesmente porque suas tags de meta estão corretas.
Q = clamp₀₋₁₀₀(metadata + trust + identity + substance − image_penalty)A classificação final recebe 15% deste resultado de qualidade normalizado. Volume de páginas e tráfego de marketing não são entradas. Atividade pública e completude do perfil
Para atividade pública, cada perfil GitHub ou Telegram acessível adiciona 15 pontos brutos, com um limite de 45. Uma nova publicação ou commit define a pontuação social para 100. Caso contrário, a atividade dentro de sete, trinta ou noventa dias adiciona 55, 40 ou 20 pontos. Links do X não são rastreados sem uma interface pública confiável. Se um produto não listar um perfil público rastreável, a pontuação social é neutra em 30, em vez de se tornar uma penalidade.
A completude é intencionalmente limitada. Um logotipo contribui com 3 pontos. Capturas de tela contribuem com 1,5 cada, até 4. Uma descrição contribui com 2 pontos a partir de 120 caracteres e 4 a partir de 300. Uma tagline adiciona 1; cobertura útil de links adiciona até 2; uma categoria adiciona 1. Adicionar dez links duplicados ou centenas de capturas de tela não aumenta o resultado.
S = min(100, 15 × reachable_profiles + freshness_bonus); S = 30 when untrackedfreshness_bonus = 55 para ≤7 dias, 40 para ≤30 dias, 20 para ≤90 dias; atividade recém-observada faz S = 100. C = logo(3) + screenshots(max 4) + description(max 4) + tagline(1) + links(max 2) + category(1)A completude é limitada naturalmente a 15 pontos e recompensa evidências úteis, em vez de volume de perfil.Votos e discussão ajudam, mas não compram o catálogo
O NeedSift utiliza votos positivos, em vez de uma escala de avaliação positiva e negativa. Portanto, um intervalo de Wilson não é o modelo adequado, enquanto uma média Bayesiana no estilo IMDb exigiria um valor de avaliação significativo para se aproximar do catálogo. Em vez disso, o NeedSift utiliza uma curva logarítmica: o apoio genuíno inicial é importante, os retornos diminuem rapidamente e a influência da comunidade atinge o limite de 15 pontos.
O topo da curva não é um número fixo de votos. Os pontos completos de votos ficam no percentil 90 dos votos ponderados de todos os produtos aprovados, com um mínimo de dez. Em termos simples, um produto recebe os doze pontos de votos quando tem mais apoio do que nove em cada dez produtos do catálogo. Usa-se um percentil em vez do máximo porque uma única listagem inflada pode mover o máximo, mas não o percentil 90. O mínimo impede que um catálogo jovem dê pontuação completa por um único voto. A escala é recalculada em cada verificação diária.
A votação requer autenticação e uma conta só pode votar uma vez por produto. Se a conta tiver menos de vinte e quatro horas de idade quando a votação for realizada, essa votação terá um peso de 0,25. Uma conta estabelecida terá 1. Isso não resolve todas as campanhas coordenadas, mas torna as contas de lançamento descartáveis quatro vezes menos eficazes e cria uma base clara para a revisão de anomalias.
W = Σ vote_weight; vote_weight = 0.25 if account_age < 24h, otherwise 1A idade da conta é medida no momento da votação, portanto, esperar mais tarde não retroativamente melhora uma votação suspeitamente recente.V_votes = 12 × min(1, ln(1 + W) / ln(1 + W₉₀)); W₉₀ = max(10, P90 of W across the catalog)Na escala mínima, um voto completo vale cerca de 3,47 pontos, três cerca de 6,94 e dez atingem o teto de 12 pontos. À medida que o catálogo cresce, W₉₀ cresce junto e o mesmo número de votos vale proporcionalmente menos.V = V_votes + V_discussionA discussão é descrita na próxima seção e adiciona no máximo 3 pontos, então V nunca passa de 15.A discussão conta um pouco
Produtos sobre os quais as pessoas falam costumam ser produtos que as pessoas usam. Desde a versão 2, o componente de comunidade também conta a discussão sob um produto. A unidade é a pessoa, não a mensagem: cada comentador distinto conta uma vez, não importa quantos comentários escreva, então uma longa discussão entre duas contas não parece uma multidão.
Só contam comentários que passaram pela moderação. Comentários do próprio criador do produto não contam: responder a perguntas é bem-vindo, mas não pode aumentar a própria pontuação. Um comentador cuja conta tinha menos de vinte e quatro horas no primeiro comentário conta como 0,25, o mesmo desconto dos votos de contas novas. Comentários ocultos, rejeitados e excluídos contam como zero.
O peso é deliberadamente pequeno. Contas são baratas e texto de comentário é fácil de gerar, então a discussão serve para desempatar produtos parecidos, não como alavanca. Ela usa a mesma escala relativa ao catálogo que os votos, com um mínimo de cinco comentadores.
D = Σ commenter_weight; commenter_weight = 0.25 if account_age < 24h at first comment, otherwise 1Uma entrada por comentador distinto com pelo menos um comentário aprovado, excluindo o criador.V_discussion = 3 × min(1, ln(1 + D) / ln(1 + D₉₀)); D₉₀ = max(5, P90 of D across the catalog)Na escala mínima, um comentador estabelecido vale cerca de 1,16 ponto, três cerca de 2,32 e cinco atingem o teto de 3 pontos.Um exemplo prático.
Considere um produto com tempo de atividade perfeito, atividade nos últimos trinta dias, uma avaliação de qualidade do site de 80, uma pontuação social de 70, treze pontos de completude e três votos estabelecidos. O produto ganha 20 pontos de tempo de atividade, 21,25 pontos de manutenção, 12 pontos de qualidade, 7 pontos sociais, 13 pontos de completude e 6,94 pontos da comunidade.
Sua pontuação final é 80,19. Mais votos ainda podem ajudar, mas mesmo atingir o limite adicionaria apenas 8,06 pontos. A melhor abordagem é melhorar a evidência do produto: consertar mídia quebrada, manter o site disponível, publicar uma versão real, completar a listagem ou adicionar um changelog útil.
20 + 21.25 + 12 + 7 + 13 + 6.94 = 80.19Exemplos de entradas: U=100, M=85, Q=80, S=70, C=13, W=3, D=0, W₉₀=10. Por que isso difere das feeds de lançamento.
Feeds com decaimento de tempo, como o Hacker News, são construídas para apresentar rapidamente as últimas notícias: a popularidade perde poder à medida que a publicação envelhece. O NeedSift tem um objetivo diferente. Um produto útil não deve desaparecer simplesmente porque foi lançado há meses, mas deve perder gradualmente pontos de manutenção se todos os sinais públicos se tornarem obsoletos. A janela de manutenção em etapas dá a novos produtos um bom começo e permite que produtos mais antigos se recuperem imediatamente, enviando trabalho verificável.
Pesquisas sobre abandono de projetos de código aberto também mostram por que uma única data de último commit não é suficiente para descrever a sobrevivência do projeto. O NeedSift não afirma que qualquer traço público prova a saúde do produto. Ele combina caminhos independentes e limita deliberadamente cada componente. A fórmula evoluirá, mas as mudanças devem permanecer explicáveis e testáveis.
A pontuação é visível, não é uma caixa preta
Cada componente é armazenado no backend e exibido na página do produto na seção "Por que essa pontuação". Os usuários podem ver o tempo de atividade, manutenção, qualidade do site, atividade social, completude e contribuição da comunidade, em vez de tentar adivinhar por que um concorrente está acima deles. As alterações na ordem do catálogo só ocorrem após o backend recalcular as pontuações; não são reorganizadas no navegador enquanto alguém está lendo.
A transparência não significa publicar todos os limites anti-abuso permanentemente. Significa publicar as regras normais, separar os fatos medidos das decisões editoriais e explicar as mudanças significativas. O objetivo não é uma definição matematicamente perfeita de qualidade. É um ranking que incentiva produtos confiáveis, manutenção honesta e trabalho público útil.
- Diretrizes do Stanford para Credibilidade na Web
- Sobre o abandono e a sobrevivência de projetos de código aberto (arXiv:1906.08058)
- Diretrizes de Avaliação de Qualidade do Google Search
- Qualidade do site como sinal de qualidade do produto (MIS Quarterly)
- Discussão no Hacker News sobre a base de classificação pública
Histórico de versões
A fórmula muda conforme o NeedSift aprende o que separa produtos mantidos de produtos abandonados. Cada versão abaixo mostra o que mudou e porquê. As pontuações são recalculadas na verificação diária seguinte à publicação de uma mudança.
- v2 — 25 de setembro de 2026. O apoio da comunidade agora combina votos (até 12 pontos) e discussão (até 3 pontos): comentadores distintos com comentários aprovados, sem o criador, com desconto para contas novas. A pontuação completa deixou de ser um número fixo de votos: fica no percentil 90 do catálogo, com mínimos de 10 votos e 5 comentadores, para que a escala cresça junto com o NeedSift.
- v1 — 24 de setembro de 2026. Primeira fórmula pública: disponibilidade 20, manutenção 25, qualidade do site 15, atividade social 10, completude 15 e votos 15 numa curva logarítmica fixa, V = min(15, 5 × ln(1 + W)), com votos de contas novas ponderados em 0,25.