NeedSift의 순위 알고리즘 내부: 모든 점수에 적용되는 공식
정확한 NeedSift 순위 공식, 신호 가중치, 신선도 창, 투표 보호, 사이트 품질 검사, 그리고 각 제품 점수에 대한 이유
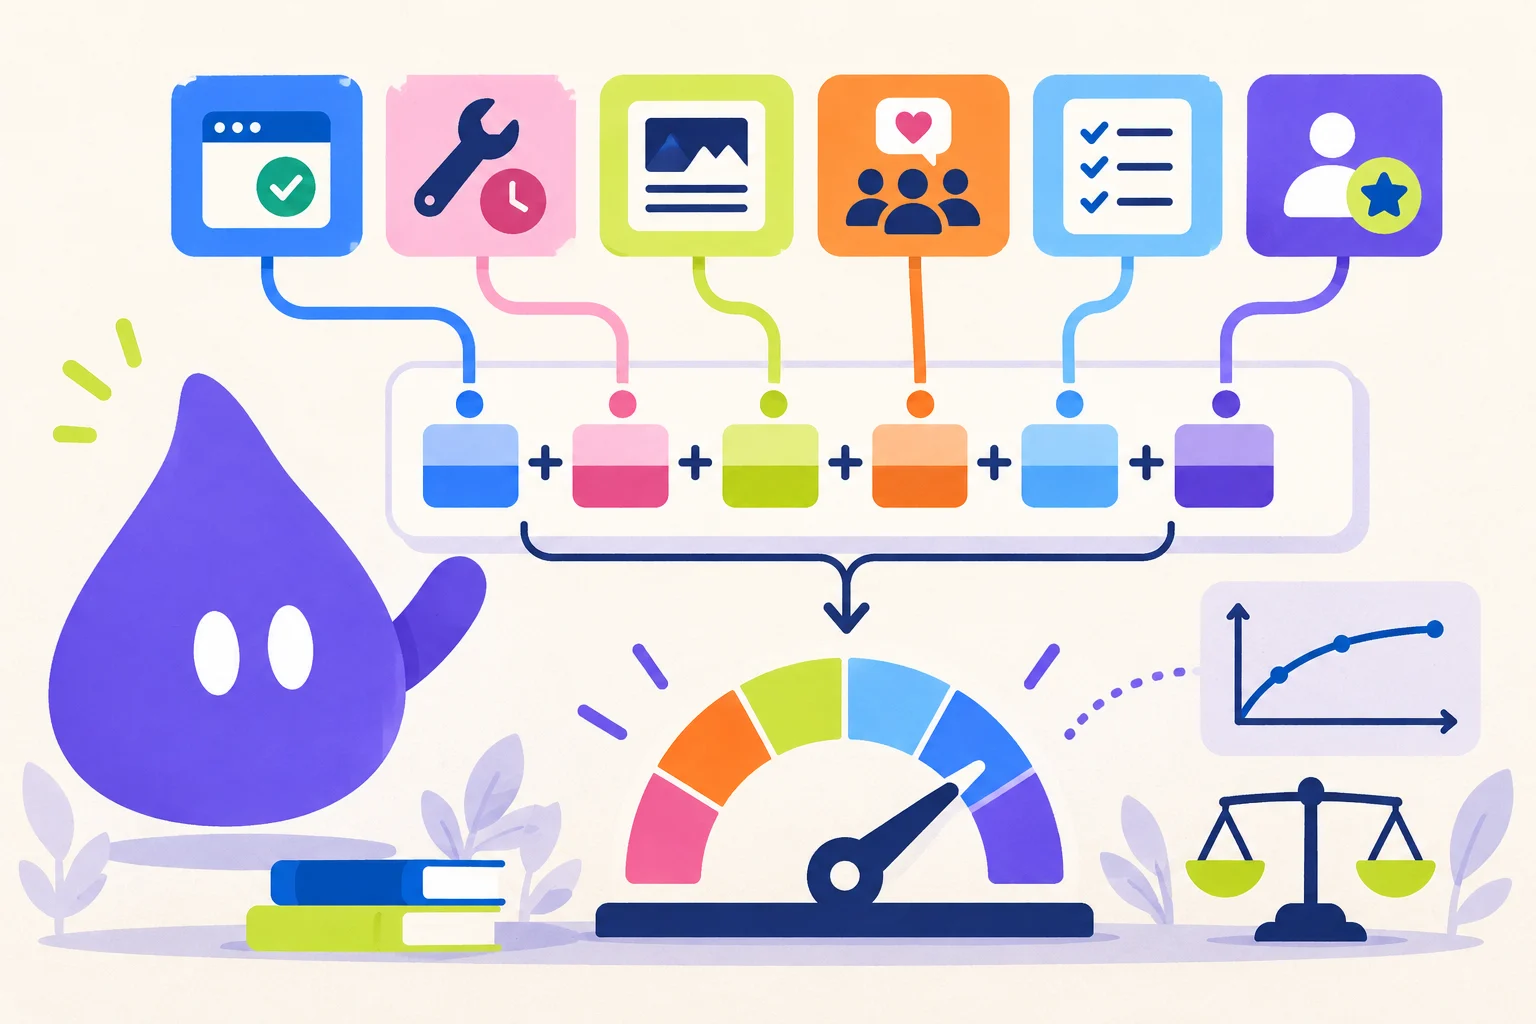
하나의 점수, 6가지 독립적인 신호
NeedSift의 카탈로그는 순수한 업보이트 수, 페이지 수, 또는 제품 제출 날짜에 따라 정렬되지 않습니다. 백엔드는 카탈로그를 반환하기 전에 0부터 100까지의 점수를 계산합니다. 동일한 저장된 점수는 모든 방문자에게 사용되므로, 하이드레이션 후 카드들이 다른 순서로 변경되지 않습니다.
이 공식은 신뢰성, 최근 유지보수, 웹사이트 품질, 공개 활동, 목록 완성도, 그리고 인증된 커뮤니티 지원을 결합합니다. 큰 규모의 사용자 기반은 제한된 커뮤니티 구성 내에서만 유용합니다. 작은 제품이 최고 순위를 달성하려면, 지속적으로 사용 가능하게 유지하고, 명확하게 설명하며, 신뢰할 수 있는 공개 증거를 유지하는 것이 중요합니다.
이 페이지는 2026년 9월 25일부터 적용된 공식의 버전 2를 설명합니다. 알고리즘의 모든 변경 사항은 글 끝의 버전 기록에 정리되어 있어, 제작자가 무엇이 왜 바뀌었는지 확인할 수 있습니다.
Score = min(100, 0.20U + 0.25M + 0.15Q + 0.10S + C + V)U, M, Q, S는 0부터 100까지 정규화됩니다. C와 V는 각각 0부터 15점까지 직접 기여합니다. 총점은 소수점 두 자리로 반올림되며, 100으로 제한됩니다. - 업타임 U: 최대 20점.
- 유지보수 M: 최대 25점.
- 웹사이트 품질 Q: 최대 15점.
- 소셜 활동 S: 최대 10점.
- 목록 완성도 C: 최대 15점.
- 커뮤니티 지지 V: 최대 15점 (투표 12점, 토론 3점).
업타임은 실제로 작동하는 제품에 보상을 제공합니다.
업타임은 최근 30일 동안의 일일 관찰을 기반으로 합니다. 성공적인 확인의 비율에서 70%가, 개별적으로 가장 빠른 응답 시간을 기준으로 30%가 차지합니다.
800밀리초 이하 또는 2초 이하의 응답은 30점의 속도 보너스를 받습니다. 5초 이하의 응답은 22점을, 더 느린 성공적인 응답은 4점을 받습니다. 정지된 도메인은 HTTP 상태와 관계없이 0점을 받습니다.
U = min(100, 70 × available_days / observed_days + speed_bonus)속도 보너스는 중앙값이 800ms 이하일 때 30; 2,000ms 이하일 때 22; 5,000ms 이하일 때 12; 그렇지 않으면 4.유지는 최신 및 검증된 날짜를 사용합니다.
제품은 매주 홈페이지를 다시 작성하여 최신 상태를 유지할 필요가 없습니다. NeedSift는 다섯 가지 독립적인 경로에서 최신 및 신뢰할 수 있는 날짜를 가져옵니다: 의미 있는 홈페이지 변경, 제품 자체의 변경 로그 또는 블로그, App Store 또는 Google Play 출시, 새로 게시된 sitemap URL, 또는 공개 GitHub 또는 Telegram 업데이트.
첫 번째 스캔은 기준을 생성하고, 이미 존재하는 모든 것이 새로운 업데이트가 아니라고 가정하지 않습니다. 제품은 NeedSift 생성 날짜로부터 7일 동안의 출시 기간을 받습니다. 그 이후에는 활동을 보여주어야 합니다. Store, sitemap, 및 소셜 하위 점수는 설명을 위해 표시되지만, 최신 검증된 날짜는 유지 관리에 통합되어 동일한 출시를 여러 번 보상하지 않습니다.
M(age) = 100 ≤7d · 85 ≤30d · 60 ≤90d · 35 ≤180d · 10 otherwise나이는 최신 검증된 활동 날짜 또는 활동이 관찰되지 않은 경우 제품 생성 날짜를 기준으로 측정됩니다.웹사이트 품질은 웹사이트 크기가 아닌 신뢰도를 측정합니다.
품질 분석기는 소규모 독립 제품에 동일한 100 점수를 큰 웹사이트에 부여할 수 있습니다. 유용한 메타데이터, 모바일 지원, favicon 및 canonical 또는 언어 신호를 찾습니다; 법적 및 연락 경로; 가격, 문서, 다운로드 또는 가입 경로; 변경 로그; 충분한 실제 제품 콘텐츠; 그리고 페이지가 실제로 나열된 제품을 설명하는지 입증하는 증거를 찾습니다.
메타데이터는 40개의 기본 품질 점수를 제공하며, 신뢰 및 제품 구조는 36, 정체성은 12, 그리고 내용성은 12입니다. 40단 이하의 페이지는 결과가 절반으로 줄어듭니다. 중단되었거나 판매용인 도메인은 0점을 받습니다. NeedSift는 최대 8개의 홈 페이지 이미지를 확인합니다: 최소 3개가 샘플링되면, 깨진 이미지는 해당 비율에 따라 10, 20, 또는 30점을 차감합니다. 따라서 시각적으로 손상된 제품 페이지가 메타 태그가 정확하더라도 완전한 품질 점수를 받을 수 없습니다.
Q = clamp₀₋₁₀₀(metadata + trust + identity + substance − image_penalty)최종 순위는 이 정규화된 품질 결과의 15%를 받습니다. 페이지의 양과 마케팅 트래픽은 입력되지 않습니다.공개 활동 및 프로필 완성도
공개 활동에 대해, 접근 가능한 GitHub 또는 Telegram 프로필은 각각 15개의 기본 점을 제공하며, 최대 45점으로 제한됩니다. 새로 관찰된 게시물 또는 커밋은 소셜 점수를 100점으로 설정합니다. 그렇지 않으면 7일, 30일 또는 90일 이내의 활동은 각각 55, 40 또는 20점을 추가합니다. X 링크는 신뢰할 수 있는 공개 인터페이스가 없으면 크롤링되지 않습니다. 제품에 추적 가능한 공개 프로필이 없는 경우, 소셜 점수는 30점으로 중립 상태를 유지하며, 벌점으로 변환되지 않습니다.
완전성은 의도적으로 제한적입니다. 로고는 3점을 제공합니다. 스크린샷은 각각 1.5점을 제공하며, 최대 4점까지입니다. 설명은 120자 이상부터 2점을, 300자 이상부터 4점을 제공합니다. 슬로건은 1점을 추가합니다. 유용한 링크 커버는 최대 2점을 추가합니다. 카테고리는 1점을 추가합니다. 10개의 중복 링크 또는 수백 개의 스크린샷을 추가해도 결과가 증가하지 않습니다.
S = min(100, 15 × reachable_profiles + freshness_bonus); S = 30 when untracked신선도 보너스는 ≤7일: 55, ≤30일: 40, ≤90일: 20; 새로 관찰된 활동은 S = 100으로 설정됩니다.C = logo(3) + screenshots(max 4) + description(max 4) + tagline(1) + links(max 2) + category(1)완전성은 자연적으로 15점으로 제한되며, 유용한 증거를 보상하는 방식으로 작동합니다. 프로필의 양보다는.투표와 토론은 도움이 되지만 카탈로그를 살 수는 없습니다
NeedSift는 긍정/부정 평가 척도 대신 긍정적인 투표를 사용합니다. 따라서 Wilson 간격은 적절한 모델이 아니며, IMDb 스타일의 베이즈 평균은 카탈로그를 기준으로 줄어드는 의미 있는 평가 값을 필요로 합니다. 대신 NeedSift는 로그 곡선을 사용합니다. 초기 진정한 지지는 중요하며, 반환은 빠르게 감소하고, 커뮤니티의 영향은 15점으로 제한됩니다.
곡선의 꼭대기는 고정된 투표 수가 아닙니다. 투표 만점은 승인된 모든 제품의 가중 투표 수 90번째 백분위수에 있으며, 최솟값은 10입니다. 쉽게 말해, 카탈로그의 제품 10개 중 9개보다 더 많은 지지를 받을 때 투표 점수 12점을 모두 얻습니다. 최댓값 대신 백분위수를 쓰는 이유는 부풀려진 목록 하나가 최댓값은 움직일 수 있어도 90번째 백분위수는 움직일 수 없기 때문입니다. 최솟값은 초기 카탈로그가 한 표만으로 만점을 주는 것을 막습니다. 이 척도는 매일 스캔할 때마다 다시 계산됩니다.
투표는 인증을 필요로 하며, 한 계정은 제품당 한 개의 투표만 할 수 있습니다. 투표가 던져질 때 계정이 24시간 미만인 경우, 해당 투표는 0.25의 가중치를 갖습니다. 확립된 계정은 1의 가중치를 갖습니다. 이는 모든 조율된 캠페인을 해결하지는 않지만, 일회용 출시일 계정을 4배 더 덜 효과적으로 만들고 이상 징후 검토를 위한 명확한 기반을 제공합니다.
W = Σ vote_weight; vote_weight = 0.25 if account_age < 24h, otherwise 1계정의 나이는 투표 시점에 측정되므로, 나중에 투표를 하더라도 의심스러운 신규 투표를 이전 상태로 되돌릴 수 없습니다.V_votes = 12 × min(1, ln(1 + W) / ln(1 + W₉₀)); W₉₀ = max(10, P90 of W across the catalog)최소 척도에서 온전한 한 표는 약 3.47점, 세 표는 약 6.94점이며, 열 표면 상한인 12점에 도달합니다. 카탈로그가 커지면 W₉₀도 함께 커지고, 같은 투표 수의 가치는 상대적으로 줄어듭니다.V = V_votes + V_discussion토론은 다음 섹션에서 설명하며 최대 3점만 더하므로 V는 15를 넘지 않습니다.토론은 조금만 반영됩니다
사람들이 이야기하는 제품은 대개 사람들이 실제로 쓰는 제품입니다. 버전 2부터 커뮤니티 요소는 제품 아래의 토론도 함께 셉니다. 단위는 메시지가 아니라 사람입니다. 서로 다른 댓글 작성자는 댓글을 몇 개 쓰든 한 번만 세므로, 두 계정 사이의 긴 논쟁이 군중처럼 보이지 않습니다.
모더레이션을 통과한 댓글만 셉니다. 제품 제작자 본인의 댓글은 세지 않습니다. 질문에 답하는 것은 환영하지만 자신의 점수를 올려서는 안 되기 때문입니다. 첫 댓글을 쓸 때 계정이 생성된 지 24시간이 안 된 작성자는 0.25로 계산하며, 이는 새 계정 투표와 같은 할인입니다. 숨김, 거절, 삭제된 댓글은 0으로 계산합니다.
가중치는 일부러 작게 두었습니다. 계정은 싸게 만들 수 있고 댓글 텍스트도 쉽게 생성할 수 있으므로, 토론은 비슷한 제품 사이의 순위를 가르는 요소일 뿐 지렛대가 아닙니다. 투표와 같은 카탈로그 기준 척도를 사용하며, 최솟값은 댓글 작성자 5명입니다.
D = Σ commenter_weight; commenter_weight = 0.25 if account_age < 24h at first comment, otherwise 1승인된 댓글이 하나 이상 있는 서로 다른 댓글 작성자마다 한 항목이며, 제작자는 제외합니다.V_discussion = 3 × min(1, ln(1 + D) / ln(1 + D₉₀)); D₉₀ = max(5, P90 of D across the catalog)최소 척도에서 기존 댓글 작성자 한 명은 약 1.16점, 세 명은 약 2.32점이며, 다섯 명이면 상한인 3점에 도달합니다.예시
완벽한 가동 시간, 지난 30일 동안의 활동, 사이트 품질 점수 80, 소셜 점수 70, 13개의 완성도 점, 그리고 3개의 확정된 투표를 갖춘 제품을 고려해 보세요. 이 제품은 20개의 가동 시간 점수, 21.25개의 유지 보수 점수, 12개의 품질 점수, 7개의 소셜 점수, 13개의 완성도 점, 그리고 6.94개의 커뮤니티 점수를 획득합니다.
최종 점수는 80.19입니다. 더 많은 투표가 도움이 될 수 있지만, 목표 점수를 달성하는 데 충분한 투표만으로는 8.06개의 추가 점수만 더 얻을 수 있습니다. 제품 자체를 개선하는 것이 더 나은 방법입니다: 고장난 미디어를 복구하고, 사이트를 계속 사용 가능하게 유지하고, 실제 릴리스를 게시하고, 목록을 완료하거나, 유용한 변경 로그를 추가하십시오.
20 + 21.25 + 12 + 7 + 13 + 6.94 = 80.19예시 입력: U=100, M=85, Q=80, S=70, C=13, W=3, D=0, W₉₀=10.이것이 런칭 피드와 어떻게 다른지
Hacker News와 같이 시간 감쇠 피드는 신규 콘텐츠를 빠르게 노출하도록 설계되었습니다: 콘텐츠가 오래될수록 인기가 쇠퇴합니다. NeedSift는 다른 역할을 수행합니다. 유용한 제품은 출시된 지 몇 달이 지났다고 해서 사라져서는 안 되지만, 모든 공개적인 정보가 오래되면 점진적으로 유지 보수 점수를 잃어야 합니다. 단계별 유지 보수 창은 새로운 제품에 공정한 시작을 제공하고, 기존 제품이 검증된 작업을 통해 즉시 회복할 수 있도록 합니다.
오픈 소스 포기에 대한 연구도, 단일 마지막 커밋 날짜만으로는 프로젝트의 생존을 설명하는 데 충분하지 않다는 것을 보여줍니다. NeedSift는 어떤 공개적인 정보라도 제품의 건강을 증명한다고 주장하지 않습니다. NeedSift는 독립적인 경로를 결합하고, 모든 구성 요소를 의도적으로 제한합니다. 공식은 진화할 수 있지만, 변경 사항은 설명 가능하고 테스트 가능해야 합니다.
점수는 검사 가능한 것이지, 블랙박스가 아닙니다
모든 구성 요소는 백엔드에서 저장되고, "왜 이 점수가 나왔나" 블록에서 제품 페이지에 노출됩니다. 개발자는 경쟁사가 자신보다 높은 위치를 차지한 이유를 추측하는 대신, 가동 시간, 유지 보수, 사이트 품질, 소셜 활동, 완성도, 커뮤니티 기여 등을 확인할 수 있습니다. 카탈로그 순서는 백엔드가 점수를 다시 계산한 후에만 변경됩니다. 누군가가 읽는 동안 브라우저에서 재정렬되지 않습니다.
투명성은 모든 종류의 악용 방지 기준을 영원히 게시하는 것을 의미하지 않습니다. 정상적인 규칙을 게시하고, 측정된 사실과 편집 결정, 그리고 중요한 변경 사항을 설명하는 것을 의미합니다. 목표는 수학적으로 완벽한 품질 정의가 아닙니다. 신뢰할 수 있는 제품, 정직한 유지 보수, 유용한 공공 작업에 초점을 맞춘 순위입니다.
버전 기록
NeedSift가 관리되는 제품과 방치된 제품을 가르는 요소를 배워 갈수록 공식도 바뀝니다. 아래 각 버전에는 무엇이 왜 바뀌었는지 적혀 있습니다. 점수는 변경이 배포된 뒤 다음 일일 스캔에서 다시 계산됩니다.
- v2 — 2026년 9월 25일. 커뮤니티 지지는 이제 투표(최대 12점)와 토론(최대 3점)을 합칩니다. 승인된 댓글이 있는 서로 다른 작성자를 세며, 제작자는 제외하고 새 계정은 할인합니다. 만점은 더 이상 고정된 투표 수가 아니라 카탈로그의 90번째 백분위수에 있으며, 최솟값은 투표 10개와 작성자 5명입니다. 그래서 척도가 NeedSift와 함께 커집니다.
- v1 — 2026년 9월 24일. 첫 공개 공식: 가용성 20, 유지 관리 25, 사이트 품질 15, 소셜 활동 10, 완성도 15, 그리고 고정 로그 곡선의 투표 15, V = min(15, 5 × ln(1 + W)). 새 계정의 투표 가중치는 0.25였습니다.