NeedSiftのランキングアルゴリズムの内側:すべてのスコアの背後にある数式
NeedSiftの正確なランキング数式、信号の重み、鮮度ウィンドウ、投票の保護、サイトの品質チェック、およびすべての製品スコアの背後にある理由。
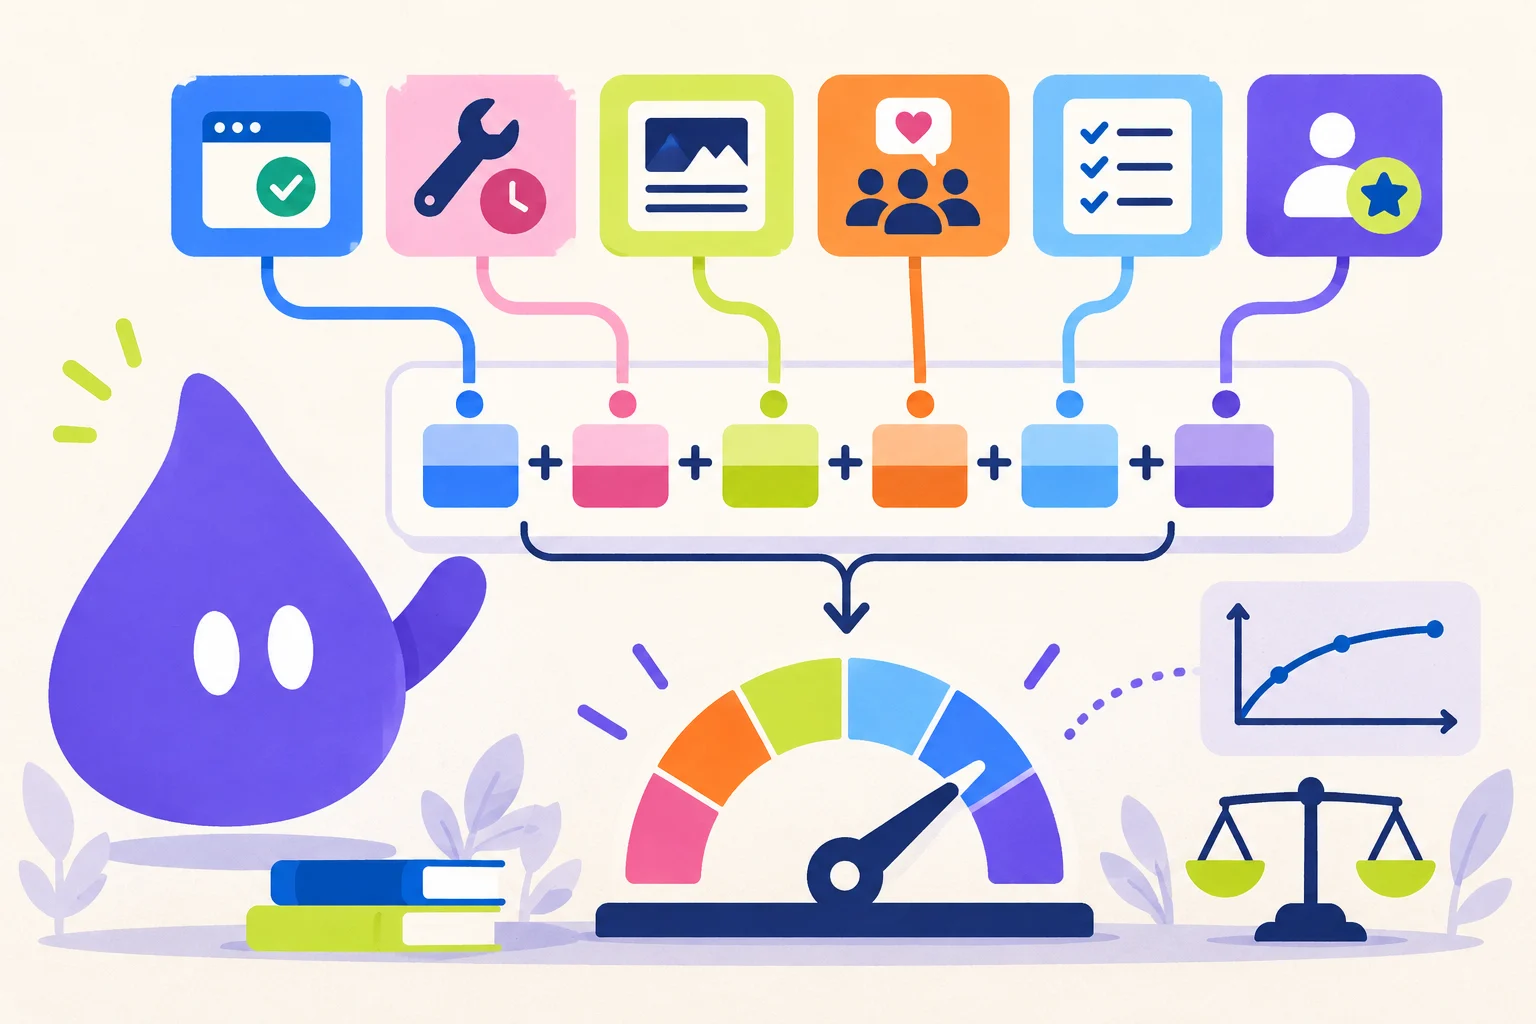
1つのスコア、6つの独立した信号
NeedSiftのカタログは、製品のアップボート数、ページ数、または製品の提出日順に並べられていません。バックエンドは、カタログを返す前に、0から100までのスコアを計算します。同じ保存されたスコアはすべての訪問者に使用されるため、カードが読み込み後に異なる順序に移動することはありません。
この式は、信頼性、最近のメンテナンス、ウェブサイトの品質、公開での活動、リストの完全性、および認証されたコミュニティのサポートを組み合わせたものです。大規模な視聴者は、限定されたコミュニティコンポーネント内でのみ有効です。小さな製品は、利用可能であること、迅速な配送、明確な説明、および信頼できる公開証拠を維持することで、上位にランクインすることができます。
このページでは、2026年9月25日から適用されている計算式のバージョン2を説明します。アルゴリズムの変更はすべて記事末尾のバージョン履歴に記載しているので、何がなぜ変わったのかを作り手が確認できます。
Score = min(100, 0.20U + 0.25M + 0.15Q + 0.10S + C + V)U、M、Q、およびSは、0から100まで正規化されます。CとVはそれぞれ0から15ポイントで直接貢献します。合計は小数点以下2桁に丸められ、100に制限されます。- 稼働時間 U: 最大20ポイント。
- メンテナンス M: 最大25ポイント。
- ウェブサイトの品質 Q: 最大15ポイント。
- ソーシャル活動 S: 最大10ポイント。
- リストの完全性 C: 最大15ポイント。
- コミュニティの支持 V:最大15ポイント(投票12、ディスカッション3)。
稼働時間は、実際に機能する製品に報酬を与えます。
稼働時間は、最新の30日間の期間からの日次観察に基づいています。コンポーネントの70%は、成功したチェックの割合から得られます。残りの30%は、成功したチェックの平均応答時間から得られ、最も速い応答時間ではなく、平均応答時間を基準とします。
800ミリ秒以下または2秒以下または5秒以下の応答には、それぞれ30ポイント、22ポイント、12ポイントの速度ボーナスが付与されます。より遅い成功した応答には、4ポイントが付与されます。パークドドメインは、HTTPステータスに関係なく、0ポイントが付与されます。
U = min(100, 70 × available_days / observed_days + speed_bonus)速度ボーナスは、中央値が800ミリ秒以下の場合に30、2,000ミリ秒以下の場合に22、5,000ミリ秒以下の場合に12、それ以外の場合は4。メンテナンスは、最新かつ検証された日付を使用します。
製品は、毎週ホームページを書き換えても活気に満ちているように見せる必要はありません。NeedSiftは、5つの独立した経路から最新かつ信頼できる日付を取得します:意味のあるホームページの変更、製品自身の変更ログまたはブログ、App StoreまたはGoogle Playのリリース、新たに公開されたsitemap URL、またはpublic GitHubまたはTelegramのアップデート。
最初のスキャンはベースラインを作成し、すでに存在するものをすべて新しいアップデートとして認識しません。製品は、NeedSiftの作成日から7日間のリリースウィンドウを受け取ります。その後、活動を示す必要があります。Store、sitemap、およびソーシャルサブスコアは、説明のために表示されたままですが、最新かつ検証された日付はメンテナンスに流れるため、同じリリースを複数回評価しません。
M(age) = 100 ≤7d · 85 ≤30d · 60 ≤90d · 35 ≤180d · 10 otherwise年齢は、最新かつ検証されたアクティビティの日付、またはアクティビティがまだ観察されていない場合は、製品の作成日から測定されます。サイトの品質は、ウェブサイトのサイズではなく、信頼性を測定します。
品質アナライザーは、小さな独立系製品に100のスコアを与えることができます。これは、大規模なウェブサイトと同じです。有用なメタデータ、モバイル対応、favicon、canonicalまたは言語信号、法的および連絡先経路、価格、ドキュメント、ダウンロード、またはサインアップ経路、変更ログ、十分な製品のコピー、およびページがリストされている製品を実際に記述していることを示す証拠を検索します。
メタデータは、品質の生のスコアにおいて最大40ポイント、信頼性と製品構造で36、アイデンティティで12、そして内容で12ポイントを貢献します。40単語未満のページは、その結果が半分になります。停用または販売中のドメインは0ポイントとなります。NeedSiftは、最大8つのホームページの画像をチェックします。少なくとも3つの画像が選択された場合、破損した画像は、その割合に応じて10、20、または30ポイントを差し引きます。そのため、メタタグが正しいにもかかわらず、視覚的に破損した製品ページは、完全な品質スコアを受け取ることができません。
Q = clamp₀₋₁₀₀(metadata + trust + identity + substance − image_penalty)最終的なランキングは、この正規化された品質の結果の15%を占めます。ページの数とマーケティングトラフィックは入力されません。公開アクティビティとプロファイルの完全性
公開アクティビティの場合、アクセス可能なGitHubまたはTelegramのプロフィールは、それぞれ15の生のポイントを追加し、最大45ポイントまでとなります。新たに投稿またはコミットが行われた場合、ソーシャルスコアは100に設定されます。それ以外の場合、7日、30日、または90日以内に発生したアクティビティは、それぞれ55、40、または20ポイントを追加します。Xへのリンクは、信頼できる公開インターフェースがない場合、クロールされません。製品が追跡可能な公開プロフィールがない場合、ソーシャルスコアは30ポイントで中立になります。
完全性は意図的に有限です。ロゴは3ポイント、スクリーンショットはそれぞれ1.5ポイント(最大4)、説明は120文字の場合に2ポイント、300文字の場合に4ポイントを貢献します。キャッチフレーズは1ポイント、役立つリンクのカバーは最大2ポイント、カテゴリは1ポイントを追加します。10個の重複したリンクまたは数百のスクリーンショットを追加しても、結果は増加しません。
S = min(100, 15 × reachable_profiles + freshness_bonus); S = 30 when untrackedfreshness_bonus = 7日以内には55、30日以内には40、90日以内には20ポイント。新たに観察されたアクティビティは、S = 100となります。C = logo(3) + screenshots(max 4) + description(max 4) + tagline(1) + links(max 2) + category(1)完全性は、自然に15点まで制限され、有用な証拠に基づいて評価され、プロファイルの内容量ではなく、評価されます。投票とディスカッションは役立つが、カタログを買うことはできない
NeedSiftは、肯定的な評価ではなく、肯定・否定の評価スケールを使用します。したがって、ウィルソンの区間は不適切なモデルであり、IMDbスタイルのベイズ平均を使用するには、カタログに向かって縮小するための意味のある評価値が必要です。代わりに、NeedSiftは対数曲線を使用します。初期の真のサポートが重要であり、収益は急速に減少し、コミュニティの影響は15点までです。
曲線の上限は固定の票数ではありません。投票の満点は、承認済みの全プロダクトの重み付き票数の90パーセンタイルに置かれ、下限は10です。簡単に言えば、カタログの10個中9個のプロダクトより多く支持されたとき、投票の12ポイントをすべて獲得します。最大値ではなくパーセンタイルを使うのは、水増しされた1件のリスティングが最大値は動かせても、90パーセンタイルは動かせないからです。下限があるため、若いカタログが1票で満点を与えることはありません。このスケールは毎日のスキャンのたびに再計算されます。
投票には認証が必要で、1つのアカウントは製品ごとに1つの投票しかできません。投票が行われた際にアカウントが24時間未満であれば、その投票は0.25の重みを持つことになります。確立されたアカウントは1の重みを持つことになります。これはすべての連携キャンペーンを解決するものではありませんが、使い捨てのローンチ日のアカウントを4倍に効果を低下させ、異常のレビューの明確な基盤を確立します。
W = Σ vote_weight; vote_weight = 0.25 if account_age < 24h, otherwise 1アカウントの年齢は投票の際に測定されるため、後で投票した場合でも、疑わしいほど新しい投票を後から改善することはできません。V_votes = 12 × min(1, ln(1 + W) / ln(1 + W₉₀)); W₉₀ = max(10, P90 of W across the catalog)最小スケールでは、1票で約3.47ポイント、3票で約6.94ポイント、10票で上限の12ポイントに達します。カタログが成長するとW₉₀も大きくなり、同じ票数の価値は相対的に小さくなります。V = V_votes + V_discussionディスカッションは次の節で説明しており、加算は最大3ポイントなので、Vが15を超えることはありません。ディスカッションも少しだけ数える
人々が話題にするプロダクトは、たいてい人々が使っているプロダクトです。バージョン2から、コミュニティの要素はプロダクトの下で行われるディスカッションも数えます。単位はメッセージではなく人です。コメント数にかかわらず、異なるコメント投稿者はそれぞれ1回だけ数えるため、2つのアカウント間の長い言い合いが大勢に見えることはありません。
モデレーションを通過したコメントだけが対象です。プロダクトの作り手自身のコメントは数えません。質問に答えるのは歓迎ですが、自分のスコアを上げてはいけないからです。最初のコメント時点でアカウント作成から24時間未満だった投稿者は0.25として数え、新しいアカウントの投票と同じ割引を適用します。非表示、却下、削除されたコメントはゼロです。
重みは意図的に小さくしています。アカウントは安く作れ、コメントの文章も簡単に生成できるため、ディスカッションは似たプロダクト同士の差をつけるためのもので、てこではありません。投票と同じカタログ相対のスケールを使い、下限は5人のコメント投稿者です。
D = Σ commenter_weight; commenter_weight = 0.25 if account_age < 24h at first comment, otherwise 1承認済みコメントが1件以上ある異なるコメント投稿者ごとに1件。作り手は除きます。V_discussion = 3 × min(1, ln(1 + D) / ln(1 + D₉₀)); D₉₀ = max(5, P90 of D across the catalog)最小スケールでは、実績あるコメント投稿者1人で約1.16ポイント、3人で約2.32ポイント、5人で上限の3ポイントに達します。具体的な例
完璧な稼働率、過去30日間のアクティビティ、サイト品質スコア80、ソーシャルスコア70、13個の完全性ポイント、および3つの確立された評価を持つ製品を検討してください。この製品は、20個の稼働率ポイント、21.25個のメンテナンスポイント、12個の品質ポイント、7個のソーシャルポイント、13個の完全性ポイント、および6.94個のコミュニティポイントを獲得します。
最終スコアは80.19です。さらに多くの評価を得ることは可能ですが、上限に達するのに十分な評価を追加しても、わずか8.06個のポイントしか追加されません。より効果的な方法は、製品の証拠を改善することです:壊れたメディアを修復し、サイトを維持し、実際のリリースを公開し、リストを完了し、または役立つ変更ログを追加します。
20 + 21.25 + 12 + 7 + 13 + 6.94 = 80.19例:U=100、M=85、Q=80、S=70、C=13、W=3, D=0, W₉₀=10。これはローンチフィードとは異なる理由
Hacker Newsのような時間経過フィードは、新鮮な情報を迅速に表示するように設計されています。投稿が古くなるにつれて、人気度は低下します。NeedSiftは異なる役割を担います。有益な製品は、単に数か月前にローンチされただけで消えるべきではありませんが、すべての公開情報が古くなると、徐々にメンテナンスポイントを失うべきです。段階的なメンテナンスウィンドウは、新しい製品に公平なスタートを与え、古い製品が、検証可能な作業をリリースすることで、すぐに回復できるようにします。
オープンソースの放棄に関する研究も、単一の最終コミット日だけではプロジェクトの生存状況を記述するのに十分ではないことを示しています。NeedSiftは、単一の公開情報が製品の健全性を証明するものではないと主張しています。独立した経路を組み合わせ、すべてのコンポーネントに上限を設定します。この公式は進化しますが、変更は説明可能でテスト可能である必要があります。
スコアは可視化可能であり、ブラックボックスではありません
すべてのコンポーネントはバックエンドで保存され、製品ページにある「なぜこのスコアなのか」ブロックで公開されます。 開発者は、競合他社がなぜ自分より上位になったのかを推測する代わりに、稼働時間、メンテナンス状況、サイトの品質、ソーシャルアクティビティ、完全性、コミュニティへの貢献などの情報を確認できます。 カタログの順序は、バックエンドがスコアを再計算した後のみ変更されます。 誰かが読みながら、ブラウザ内で再配置されません。
透明性とは、すべての不正行為の閾値を永久に公開することを意味しません。 意味は、通常のルールを公開し、測定された事実と編集上の決定を区別し、重要な変更を説明することです。 目標は、数学的に完璧な品質の定義ではありません。 信頼できる製品、誠実なメンテナンス、そして有益な公共の取り組みを指向するランキングです。
バージョン履歴
計算式は、手入れされているプロダクトと放置されたプロダクトを分けるものをNeedSiftが学ぶにつれて変わります。以下の各バージョンに、何がなぜ変わったかを記載しています。スコアは変更の公開後、次の毎日のスキャンで再計算されます。
- v2 — 2026年9月25日。コミュニティの支持は投票(最大12ポイント)とディスカッション(最大3ポイント)の組み合わせになりました。対象は承認済みコメントを持つ異なる投稿者で、作り手を除き、新しいアカウントは割り引きます。満点はもはや固定の票数ではなく、カタログの90パーセンタイルに置かれ、下限は10票と5人です。これによりスケールはNeedSiftとともに大きくなります。
- v1 — 2026年9月24日。最初の公開計算式:稼働率20、メンテナンス25、サイト品質15、ソーシャル活動10、完成度15、そして固定の対数曲線による投票15、V = min(15, 5 × ln(1 + W))。新しいアカウントの投票の重みは0.25でした。