Di Dalam Algoritma Peringkat NeedSift: Rumus di Balik Setiap Skor
Rumus peringkat NeedSift yang tepat, bobot sinyal, jendela waktu, perlindungan suara, pemeriksaan kualitas situs, dan alasan di balik setiap skor produk.
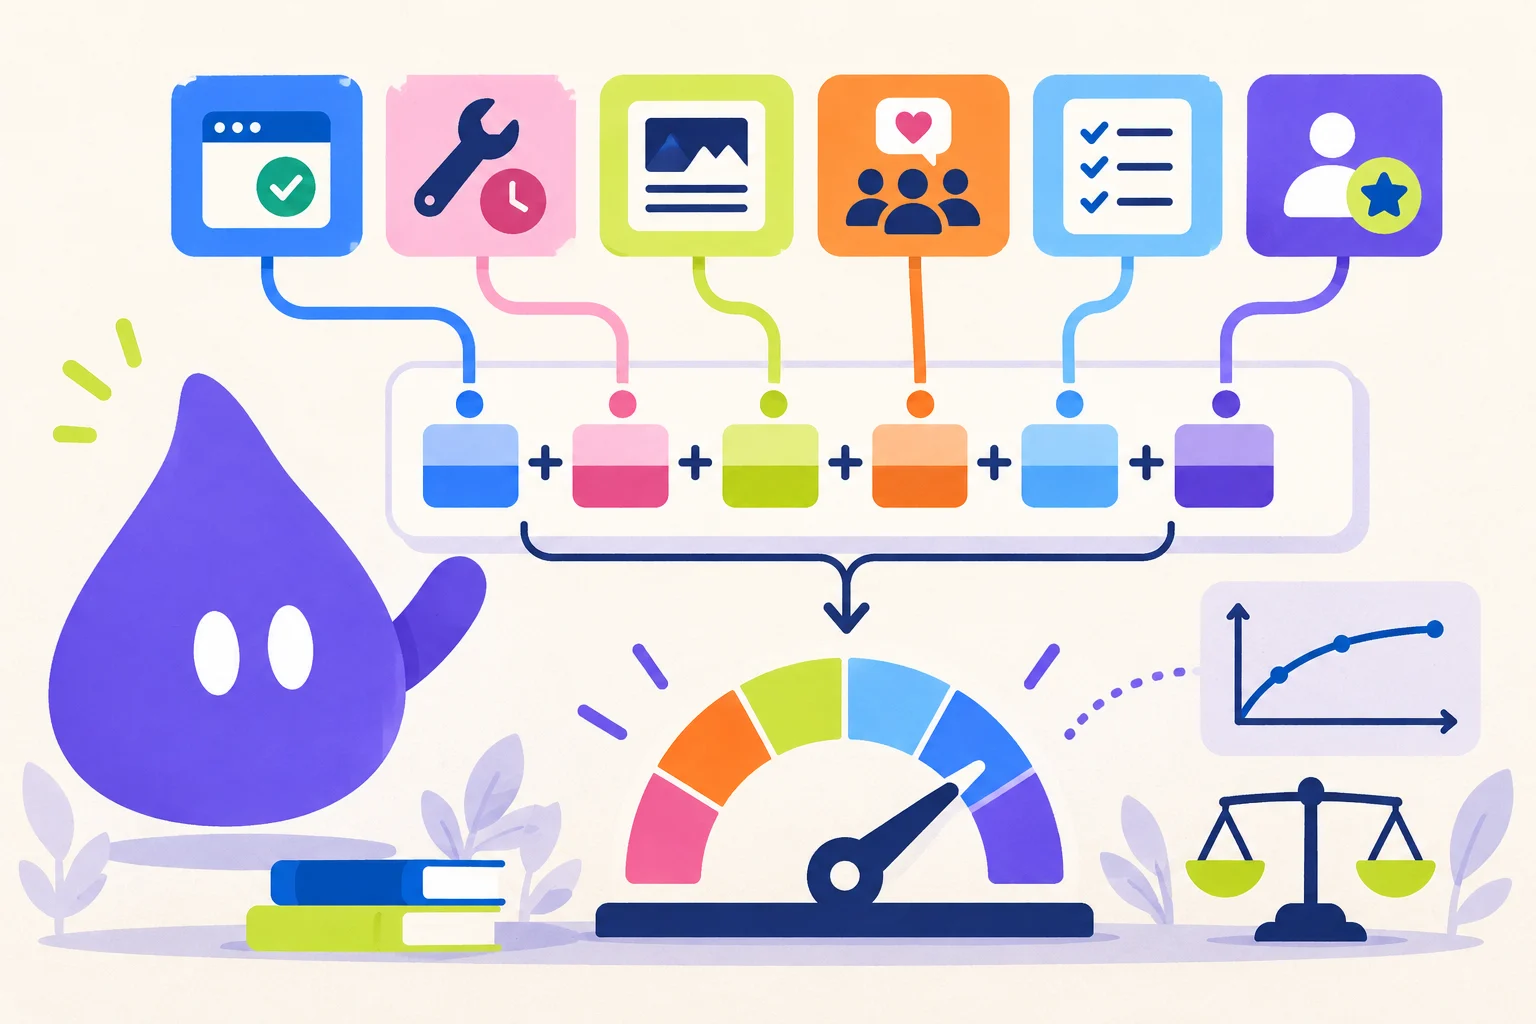
Satu skor, enam sinyal independen
Katalog NeedSift tidak diurutkan berdasarkan jumlah upvote mentah, jumlah halaman, atau tanggal produk dikirimkan. Backend menghitung skor dari nol hingga seratus sebelum mengembalikan katalog. Skor yang sama digunakan oleh setiap pengunjung, sehingga kartu tidak berpindah urutan setelah dimuat.
Rumus ini menggabungkan keandalan, pemeliharaan terbaru, kualitas situs web, aktivitas publik, kelengkapan daftar, dan dukungan komunitas yang terverifikasi. Audiens yang besar hanya membantu di dalam komponen komunitas yang terbatas. Produk kecil dapat mencapai peringkat teratas dengan tetap tersedia, dikirim, menjelaskan diri dengan jelas, dan mempertahankan bukti publik yang kredibel.
Halaman ini menjelaskan versi 2 dari rumus, berlaku sejak 25 September 2026. Setiap perubahan algoritma dicatat dalam riwayat versi di akhir artikel, agar para pembuat produk bisa melihat apa yang berubah dan mengapa.
Score = min(100, 0.20U + 0.25M + 0.15Q + 0.10S + C + V)U, M, Q, dan S dinormalisasi dari 0 hingga 100. C dan V berkontribusi langsung dari 0 hingga 15 poin masing-masing. Totalnya dibulatkan menjadi dua desimal dan dibatasi hingga 100.- Uptime U: hingga 20 poin.
- Pemeliharaan M: hingga 25 poin.
- Kualitas situs web Q: hingga 15 poin.
- Aktivitas sosial S: hingga 10 poin.
- Kelengkapan daftar C: hingga 15 poin.
- Dukungan komunitas V: hingga 15 poin (12 dari suara, 3 dari diskusi).
Uptime memberikan penghargaan kepada produk yang benar-benar berfungsi.
Uptime didasarkan pada observasi harian dari jendela 30 hari terakhir. Tujuh puluh persen dari komponen berasal dari proporsi pemeriksaan yang berhasil. Sisa 30 persen berasal dari waktu respons median pemeriksaan yang berhasil, bukan respons tercepat.
Respons pada atau di bawah 800 milidetik menerima bonus kecepatan 30 poin; pada atau di bawah 2 detik menerima 22 poin; pada atau di bawah 5 detik menerima 12 poin; respons yang berhasil tetapi lebih lambat menerima 4 poin. Domain yang tidak aktif menerima 0, terlepas dari status HTTP-nya.
U = min(100, 70 × available_days / observed_days + speed_bonus)speed_bonus = 30 ketika median ≤ 800 ms; 22 ketika ≤ 2.000 ms; 12 ketika ≤ 5.000 ms; jika tidak, 4.Pemeliharaan menggunakan tanggal yang paling baru dan terverifikasi.
Sebuah produk tidak perlu menulis ulang halaman utamanya setiap minggu agar tetap terlihat segar. NeedSift mengambil tanggal yang paling baru dan terpercaya dari lima jalur independen: perubahan halaman utama yang bermakna, changelog atau blog produk, rilis di App Store atau Google Play, URL sitemap yang baru diterbitkan, atau pembaruan publik di GitHub atau Telegram.
Pemindaian pertama membuat baseline dan tidak menganggap bahwa semua yang ada sudah merupakan pembaruan baru. Sebuah produk juga menerima jendela peluncuran selama 7 hari dari tanggal pembuatan NeedSift. Setelah itu, produk harus menunjukkan aktivitas. Skor sub untuk Store, sitemap, dan media sosial tetap terlihat untuk penjelasan, tetapi tanggal yang paling baru dan terverifikasi mengalir ke pemeliharaan sehingga total tidak memberikan penghargaan pada rilis yang sama beberapa kali.
M(age) = 100 ≤7d · 85 ≤30d · 60 ≤90d · 35 ≤180d · 10 otherwiseusia diukur dari tanggal aktivitas yang paling baru dan terverifikasi atau, jika belum ada aktivitas yang teramati, tanggal pembuatan produk.Kualitas situs mengukur kepercayaan, bukan ukuran situs web.
Analisis kualitas dapat memberikan nilai 100 yang sama untuk produk indie satu halaman ke situs web besar. Ini mencari metadata yang berguna, dukungan seluler, favicon, dan sinyal canonical atau bahasa; rute hukum dan kontak; jalur harga, dokumentasi, unduhan, atau pendaftaran; changelog; konten produk yang cukup; dan bukti bahwa halaman tersebut benar-benar menggambarkan produk yang terdaftar.
Metadata memberikan hingga 40 poin kualitas mentah, kepercayaan dan struktur produk 36, identitas 12, dan substansi 12. Halaman dengan kurang dari empat puluh kata akan mendapatkan hasil yang setengahnya. Domain yang tidak aktif atau dijual menerima nol. NeedSift memeriksa maksimal delapan gambar di halaman utama: jika setidaknya tiga gambar diambil, gambar yang rusak mengurangi 10, 20, atau 30 poin tergantung pada persentase. Inilah mengapa halaman produk yang rusak secara visual tidak dapat menerima kredit kualitas penuh hanya karena tag meta-nya sudah benar.
Q = clamp₀₋₁₀₀(metadata + trust + identity + substance − image_penalty)Peringkat akhir menerima 15% dari hasil kualitas yang dinormalisasi ini. Volume halaman dan lalu lintas pemasaran bukanlah input.Aktivitas publik dan kelengkapan profil
Untuk aktivitas publik, setiap profil GitHub atau Telegram yang dapat diakses menambahkan 15 poin mentah, dengan batas maksimal 45. Posting atau komit baru akan menetapkan skor sosial menjadi 100. Jika tidak, aktivitas dalam tujuh, tiga puluh, atau sembilan puluh hari menambahkan 55, 40, atau 20 poin. Tautan X tidak di-crawl tanpa antarmuka publik yang andal. Jika produk tidak mencantumkan profil publik yang dapat dilacak, skor sosial akan netral pada 30 daripada menjadi penalti.
Kelengkapan sengaja terbatas. Logo memberikan 3 poin. Tangkapan layar memberikan 1,5 poin masing-masing hingga 4. Deskripsi memberikan 2 poin dari 120 karakter dan 4 dari 300. Tagline menambahkan 1; cakupan tautan yang berguna menambahkan hingga 2; kategori menambahkan 1. Menambahkan sepuluh tautan duplikat atau ratusan tangkapan layar tidak dapat meningkatkan hasil.
S = min(100, 15 × reachable_profiles + freshness_bonus); S = 30 when untrackedfreshness_bonus = 55 untuk ≤7 hari, 40 untuk ≤30 hari, 20 untuk ≤90 hari; aktivitas yang baru diamati membuat S = 100.C = logo(3) + screenshots(max 4) + description(max 4) + tagline(1) + links(max 2) + category(1)Kelengkapan dibatasi secara alami pada 15 poin dan memberikan penghargaan atas bukti yang berguna, bukan volume profil.Suara dan diskusi membantu, tetapi tidak bisa membeli katalog
NeedSift memiliki suara positif, bukan skala peringkat positif-negatif. Oleh karena itu, interval Wilson bukanlah model yang tepat, sementara rata-rata Bayesian gaya IMDb akan membutuhkan nilai peringkat yang bermakna untuk menyusut menuju katalog. Sebagai gantinya, NeedSift menggunakan kurva logaritmik: dukungan awal yang asli penting, pengembalian dengan cepat berkurang, dan pengaruh komunitas berhenti pada 15 poin.
Puncak kurva bukan jumlah suara yang tetap. Poin suara penuh berada di persentil ke-90 dari suara berbobot seluruh produk yang disetujui, dengan batas bawah sepuluh. Sederhananya, sebuah produk mendapat dua belas poin suara penuh ketika dukungannya lebih besar daripada sembilan dari sepuluh produk di katalog. Persentil dipakai alih-alih nilai maksimum karena satu listing yang digelembungkan bisa menggeser maksimum, tetapi tidak bisa menggeser persentil ke-90. Batas bawah mencegah katalog yang masih muda memberi poin penuh untuk satu suara. Skala dihitung ulang pada setiap pemindaian harian.
Pemungutan suara memerlukan autentikasi, dan satu akun hanya dapat memberikan satu suara per produk. Jika akun tersebut berusia kurang dari 24 jam ketika suara diberikan, suara tersebut akan memiliki bobot 0,25. Akun yang sudah mapan akan menerima 1. Ini tidak menyelesaikan setiap kampanye yang terkoordinasi, tetapi membuat akun peluncuran yang sekali pakai 4 kali kurang efektif dan menciptakan dasar yang jelas untuk peninjauan anomali.
W = Σ vote_weight; vote_weight = 0.25 if account_age < 24h, otherwise 1Usia akun diukur pada saat pemungutan suara, jadi menunggu lebih lama tidak secara retroaktif meningkatkan suara yang mencurigakan karena baru.V_votes = 12 × min(1, ln(1 + W) / ln(1 + W₉₀)); W₉₀ = max(10, P90 of W across the catalog)Pada skala minimum, satu suara penuh bernilai sekitar 3,47 poin, tiga suara sekitar 6,94, dan sepuluh mencapai batas 12 poin. Saat katalog tumbuh, W₉₀ ikut tumbuh sehingga jumlah suara yang sama bernilai lebih kecil secara proporsional.V = V_votes + V_discussionDiskusi dijelaskan di bagian berikutnya dan menambah paling banyak 3 poin, jadi V tidak pernah melebihi 15.Diskusi dihitung sedikit
Produk yang dibicarakan orang biasanya adalah produk yang dipakai orang. Sejak versi 2, komponen komunitas juga menghitung diskusi di bawah sebuah produk. Satuannya adalah orang, bukan pesan: setiap komentator berbeda dihitung sekali, berapa pun komentar yang ia tulis, sehingga perdebatan panjang antara dua akun tidak terlihat seperti keramaian.
Hanya komentar yang lolos moderasi yang dihitung. Komentar dari pembuat produk sendiri tidak dihitung: menjawab pertanyaan itu baik, tetapi tidak boleh menaikkan skornya sendiri. Komentator yang akunnya berumur kurang dari dua puluh empat jam saat komentar pertamanya dihitung 0,25, potongan yang sama dengan suara dari akun baru. Komentar yang disembunyikan, ditolak, dan dihapus dihitung nol.
Bobotnya sengaja kecil. Akun itu murah dan teks komentar mudah dibuat, jadi diskusi hanya menjadi penentu di antara produk yang mirip, bukan tuas. Diskusi memakai skala relatif terhadap katalog yang sama dengan suara, dengan batas bawah lima komentator.
D = Σ commenter_weight; commenter_weight = 0.25 if account_age < 24h at first comment, otherwise 1Satu entri untuk setiap komentator berbeda yang memiliki minimal satu komentar yang disetujui, tidak termasuk pembuat produk.V_discussion = 3 × min(1, ln(1 + D) / ln(1 + D₉₀)); D₉₀ = max(5, P90 of D across the catalog)Pada skala minimum, satu komentator mapan bernilai sekitar 1,16 poin, tiga sekitar 2,32, dan lima mencapai batas 3 poin.Contoh penerapan
Pertimbangkan sebuah produk dengan uptime yang sempurna, aktivitas dalam tiga puluh hari terakhir, hasil kualitas situs sebesar 80, skor sosial sebesar 70, tiga belas poin kelengkapan, dan tiga suara yang terverifikasi. Produk tersebut memperoleh 20 poin uptime, 21,25 poin pemeliharaan, 12 poin kualitas, 7 poin sosial, 13 poin kelengkapan, dan 6,94 poin komunitas.
Skor akhirnya adalah 80,19. Lebih banyak suara masih bisa membantu, tetapi bahkan jumlah suara yang cukup untuk mencapai batas maksimum hanya akan menambahkan 8,06 poin lagi. Jalur yang lebih baik adalah meningkatkan bukti produk itu sendiri: memperbaiki media yang rusak, menjaga situs tetap tersedia, menerbitkan rilis yang nyata, menyelesaikan daftar, atau menambahkan changelog yang bermanfaat.
20 + 21.25 + 12 + 7 + 13 + 6.94 = 80.19Contoh input: U=100, M=85, Q=80, S=70, C=13, W=3, D=0, W₉₀=10. Mengapa ini berbeda dari umpan peluncuran.
Umpan yang mengalami penurunan seiring waktu, seperti Hacker News, dirancang untuk menampilkan cerita terbaru dengan cepat: popularitas kehilangan kekuatannya seiring waktu. NeedSift memiliki tujuan yang berbeda. Sebuah produk yang bermanfaat seharusnya tidak hilang hanya karena diluncurkan beberapa bulan lalu, tetapi seharusnya secara bertahap kehilangan kredit pemeliharaan jika setiap tanda publik menjadi usang. Jendela pemeliharaan yang bertahap memberi produk baru kesempatan yang adil dan memungkinkan produk yang lebih tua untuk pulih dengan segera dengan mengirimkan pekerjaan yang terverifikasi.
Penelitian tentang pengabaian proyek sumber terbuka juga menunjukkan mengapa tanggal komit terakhir saja tidak cukup untuk menggambarkan kelangsungan proyek. NeedSift tidak mengklaim bahwa satu jejak publik pun membuktikan kesehatan produk. Ini menggabungkan jalur independen dan secara sengaja membatasi setiap komponen. Rumusnya akan berkembang, tetapi perubahan harus tetap dapat dijelaskan dan diuji.
Skor dapat diperiksa, bukan sesuatu yang tersembunyi
Setiap komponen disimpan oleh backend dan ditampilkan di halaman produk pada blok “Mengapa skor ini”, para pengembang dapat melihat uptime, pemeliharaan, kualitas situs, aktivitas sosial, kelengkapan, dan kontribusi komunitas, daripada menebak mengapa pesaing berada di atas mereka. Perubahan urutan katalog hanya terjadi setelah backend menghitung ulang skor; ini tidak diubah di browser saat seseorang sedang membaca.
Transparansi tidak berarti mempublikasikan setiap ambang batas anti-penyalahgunaan secara permanen. Ini berarti mempublikasikan aturan normal, memisahkan fakta yang diukur dari keputusan editorial, dan menjelaskan perubahan materi. Tujuannya bukan definisi kualitas yang sempurna secara matematis. Ini adalah peringkat yang mendorong produk yang andal, pemeliharaan yang jujur, dan karya publik yang bermanfaat.
Riwayat versi
Rumus berubah seiring NeedSift mempelajari apa yang membedakan produk yang terawat dari produk yang ditinggalkan. Setiap versi di bawah mencantumkan apa yang berubah dan mengapa. Skor dihitung ulang pada pemindaian harian berikutnya setelah perubahan dirilis.
- v2 — 25 September 2026. Dukungan komunitas kini menggabungkan suara (hingga 12 poin) dan diskusi (hingga 3 poin): komentator berbeda dengan komentar yang disetujui, tidak termasuk pembuat produk, dengan potongan untuk akun baru. Poin penuh tidak lagi berupa jumlah suara yang tetap: letaknya di persentil ke-90 katalog, dengan batas bawah 10 suara dan 5 komentator, sehingga skala tumbuh bersama NeedSift.
- v1 — 24 September 2026. Rumus publik pertama: ketersediaan 20, pemeliharaan 25, kualitas situs 15, aktivitas sosial 10, kelengkapan 15, dan suara 15 pada kurva logaritmik tetap, V = min(15, 5 × ln(1 + W)), dengan suara akun baru berbobot 0,25.