À l'intérieur de l'algorithme de classement de NeedSift : La formule derrière chaque note
La formule de classement exacte de NeedSift, les pondérations des signaux, les fenêtres de fraîcheur, les mesures de sécurité des votes, les contrôles de qualité du site, et la justification de chaque note de produit.
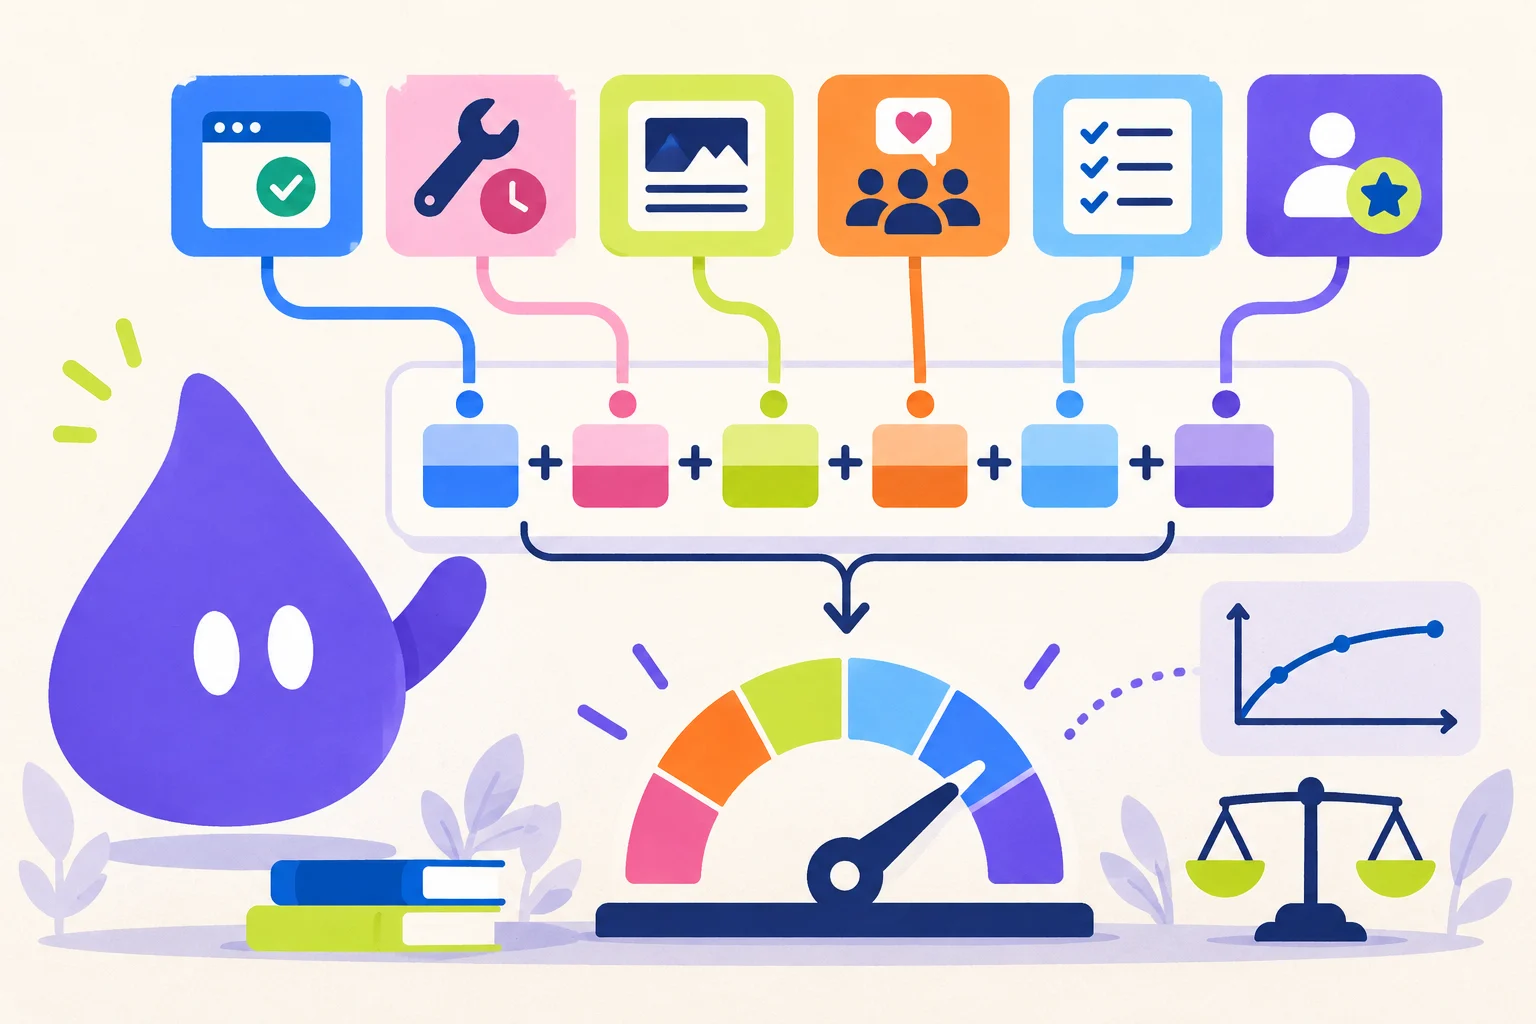
Un seul score, six signaux indépendants
Le catalogue de NeedSift n'est pas trié en fonction des votes bruts, du nombre de pages ou de la date de soumission du produit. Le backend calcule un score de zéro à cent avant de renvoyer le catalogue. Le même score enregistré est utilisé par chaque visiteur, de sorte que les cartes ne changent pas d'ordre après la mise en page.
La formule combine la fiabilité, la maintenance récente, la qualité du site web, l'activité publique, l'exhaustivité de la liste, et le soutien de la communauté authentifié. Un grand public ne contribue qu'à l'intérieur du composant de communauté limité. Un petit produit peut atteindre le sommet en restant disponible, en étant expédié, en s'exprimant clairement, et en maintenant des preuves publiques crédibles.
Cette page décrit la version 2 de la formule, en vigueur depuis le 25 septembre 2026. Chaque modification de l’algorithme figure dans l’historique des versions à la fin de l’article, afin que les créateurs voient ce qui a changé et pourquoi.
Score = min(100, 0.20U + 0.25M + 0.15Q + 0.10S + C + V)U, M, Q et S sont normalisés de 0 à 100. C et V contribuent directement de 0 à 15 points chacun. Le total est arrondi à deux décimales et plafonné à 100.- Le temps de disponibilité (Uptime) : jusqu'à 20 points.
- Maintenance (M) : jusqu'à 25 points.
- Qualité du site web (Q) : jusqu'à 15 points.
- Activité sociale (S) : jusqu'à 10 points.
- Exhaustivité de la liste (C) : jusqu'à 15 points.
- Soutien de la communauté V : jusqu’à 15 points (12 pour les votes, 3 pour la discussion).
Le temps de disponibilité récompense un produit qui fonctionne réellement.
Le temps de disponibilité est basé sur des observations quotidiennes de la dernière fenêtre de 30 jours. 70 % du composant proviennent du pourcentage de vérifications réussies. Les 30 % restants proviennent du temps de réponse médian des vérifications réussies, et non de la réponse la plus rapide.
Une réponse d'au moins 800 millisecondes reçoit un bonus de vitesse de 30 points ; d'au moins 2 secondes, elle reçoit 22 points ; d'au moins 5 secondes, elle reçoit 12 points ; une réponse réussie plus lente reçoit 4 points. Un domaine "parké" reçoit zéro, quel que soit son statut HTTP.
U = min(100, 70 × available_days / observed_days + speed_bonus)speed_bonus = 30 lorsque la médiane ≤ 800 ms ; 22 lorsque ≤ 2 000 ms ; 12 lorsque ≤ 5 000 ms ; sinon 4.La maintenance utilise la date la plus récente et vérifiée.
Un produit ne devrait pas avoir besoin de réécrire sa page d'accueil chaque semaine pour rester à jour. NeedSift extrait la date la plus récente et la plus fiable de cinq sources indépendantes : une modification significative de la page d'accueil, le journal des modifications ou le blog du produit, une publication sur l'App Store ou Google Play, une URL de sitemap nouvellement publiée, ou une mise à jour publique sur GitHub ou Telegram.
Le premier scan crée une base de référence et ne prétend pas que tout ce qui est présent est une nouvelle mise à jour. Un produit reçoit également une fenêtre de lancement de sept jours à partir de sa création NeedSift. Après cela, il doit démontrer une activité. Les scores de maintenance, de sitemap et de réseaux sociaux restent visibles à des fins d'explication, mais leurs dates les plus récentes et vérifiées sont intégrées à la maintenance afin que le total ne récompense pas la même publication plusieurs fois.
M(age) = 100 ≤7d · 85 ≤30d · 60 ≤90d · 35 ≤180d · 10 otherwiseL'âge est mesuré à partir de la date d'activité la plus récente et vérifiée, ou, si aucune activité n'a été observée, à partir de la date de création du produit.La qualité du site mesure la confiance, et non la taille du site web.
L'analyseur de qualité peut attribuer une note de 100 à un petit produit indépendant d'une seule page, tout comme à un grand site web. Il recherche des métadonnées utiles, le support mobile, une icône de site web et un signal canonique ou de langue ; des itinéraires légaux et de contact ; des chemins de tarification, de documentation, de téléchargement ou d'inscription ; un journal des modifications ; suffisamment de contenu réel du produit ; et des preuves que la page décrit réellement le produit mentionné.
Les métadonnées contribuent jusqu'à 40 points de qualité bruts, ainsi que la confiance et la structure du produit (36), l'identité (12) et la substance (12). Une page contenant moins de quarante mots voit son résultat divisé par deux. Un domaine mis en vente ou non utilisé reçoit un score de zéro. NeedSift vérifie au maximum huit images de la page d'accueil : lorsque au moins trois sont sélectionnées, les images défectueuses soustraient 10, 20 ou 30 points, selon leur proportion. C'est pourquoi une page de produit visuellement défectueuse ne peut pas recevoir un crédit de qualité complet simplement parce que ses balises méta sont correctes.
Q = clamp₀₋₁₀₀(metadata + trust + identity + substance − image_penalty)Le classement final reçoit 15 % de ce résultat de qualité normalisé. Le volume de pages et le trafic marketing ne sont pas des facteurs.Activité publique et complétude du profil
Pour l'activité publique, chaque profil GitHub ou Telegram accessible ajoute 15 points bruts, avec un maximum de 45. Un nouveau message ou un commit définit le score social à 100. Sinon, l'activité dans les 7, 30 ou 90 jours ajoute 55, 40 ou 20 points. Les liens X ne sont pas indexés sans une interface publique fiable. Si un produit n'a pas de profil public accessible, le score social est neutre à 30 au lieu de devenir une pénalité.
La complétude est intentionnellement limitée. Un logo contribue avec 3 points. Les captures d'écran contribuent avec 1,5 chacun jusqu'à 4. Une description contribue avec 2 points à partir de 120 caractères et 4 à partir de 300. Un slogan ajoute 1 point ; la couverture des liens utiles ajoute jusqu'à 2 points ; une catégorie ajoute 1 point. L'ajout de dix liens dupliqués ou de centaines de captures d'écran ne peut pas augmenter le résultat.
S = min(100, 15 × reachable_profiles + freshness_bonus); S = 30 when untrackedfreshness_bonus = 55 pour ≤7 jours, 40 pour ≤30 jours, 20 pour ≤90 jours ; l'activité nouvellement observée fait que S = 100.C = logo(3) + screenshots(max 4) + description(max 4) + tagline(1) + links(max 2) + category(1)La complétude est plafonnée à 15 points et récompense les preuves utiles plutôt que le volume de profil.Les votes et la discussion aident, mais n’achètent pas le catalogue
NeedSift utilise des votes positifs plutôt qu'une échelle de notation positive et négative. Un intervalle de Wilson est donc le mauvais modèle, tandis qu'une moyenne bayésienne de type IMDb nécessiterait une valeur de notation significative pour se rapprocher d'un catalogue. À la place, NeedSift utilise une courbe logarithmique : le soutien initial et authentique est important, les retours diminuent rapidement, et l'influence de la communauté s'arrête à quinze points.
Le haut de la courbe n’est pas un nombre fixe de votes. Les points de vote complets se situent au 90e centile des votes pondérés de tous les produits approuvés, avec un minimum de dix. Autrement dit, un produit obtient les douze points de vote lorsqu’il est plus soutenu que neuf produits sur dix du catalogue. On utilise un centile plutôt que le maximum, car une seule fiche gonflée peut déplacer le maximum, mais pas le 90e centile. Le plancher empêche un jeune catalogue de distribuer tous les points pour un seul vote. L’échelle est recalculée à chaque analyse quotidienne.
Le vote nécessite une authentification et un seul compte ne peut faire qu'un seul vote par produit. Si le compte a moins de vingt-quatre heures, ce vote reçoit un poids de 0,25. Un compte établi reçoit 1. Cela ne résout pas toutes les campagnes coordonnées, mais rend les comptes de lancement temporaires quatre fois moins efficaces et crée une base claire pour l'examen des anomalies.
W = Σ vote_weight; vote_weight = 0.25 if account_age < 24h, otherwise 1L'âge du compte est mesuré au moment du vote, de sorte qu'attendre plus tard ne modifie pas rétroactivement un vote nouvellement créé.V_votes = 12 × min(1, ln(1 + W) / ln(1 + W₉₀)); W₉₀ = max(10, P90 of W across the catalog)À l’échelle minimale, un vote complet vaut environ 3,47 points, trois environ 6,94, et dix atteignent le plafond de 12 points. Quand le catalogue grandit, W₉₀ grandit avec lui et le même nombre de votes vaut proportionnellement moins.V = V_votes + V_discussionLa discussion est décrite dans la section suivante et ajoute au plus 3 points, donc V ne dépasse jamais 15.La discussion compte un peu
Les produits dont on parle sont généralement des produits que l’on utilise. Depuis la version 2, la composante communautaire compte aussi la discussion sous un produit. L’unité est la personne, pas le message : chaque commentateur distinct compte une fois, quel que soit le nombre de ses commentaires, si bien qu’un long échange entre deux comptes ne ressemble pas à une foule.
Seuls les commentaires ayant passé la modération comptent. Ceux du créateur du produit ne comptent pas : répondre aux questions est bienvenu, mais ne doit pas faire monter son propre score. Un commentateur dont le compte avait moins de vingt-quatre heures lors de son premier commentaire compte pour 0,25, la même réduction que pour les votes de comptes récents. Les commentaires masqués, rejetés et supprimés comptent pour zéro.
Le poids est volontairement faible. Les comptes coûtent peu et un commentaire se génère facilement : la discussion sert à départager des produits comparables, pas de levier. Elle suit la même échelle relative au catalogue que les votes, avec un plancher de cinq commentateurs.
D = Σ commenter_weight; commenter_weight = 0.25 if account_age < 24h at first comment, otherwise 1Une entrée par commentateur distinct ayant au moins un commentaire approuvé, créateur exclu.V_discussion = 3 × min(1, ln(1 + D) / ln(1 + D₉₀)); D₉₀ = max(5, P90 of D across the catalog)À l’échelle minimale, un commentateur établi vaut environ 1,16 point, trois environ 2,32, et cinq atteignent le plafond de 3 points.Un exemple concret
Envisagez un produit avec une disponibilité parfaite, une activité des trente derniers jours, un résultat de qualité du site de 80, un score social de 70, treize points de complétude, et trois votes établis. Le produit obtient 20 points de disponibilité, 21,25 points de maintenance, 12 points de qualité, 7 points sociaux, 13 points de complétude, et 6,94 points de communauté.
Son score final est de 80,19. Plus de votes peuvent encore aider, mais même un nombre suffisant de votes pour atteindre la limite n'ajouterait que 8,06 points supplémentaires. La meilleure approche est d'améliorer les preuves du produit : réparer les médias, maintenir le site disponible, publier une version réelle, compléter la fiche, ou ajouter un journal de bord utile.
20 + 21.25 + 12 + 7 + 13 + 6.94 = 80.19Exemples d'entrées : U=100, M=85, Q=80, S=70, C=13, W=3, D=0, W₉₀=10. Pourquoi cela diffère des flux de lancement.
Les flux de déclin temporel, comme Hacker News, sont conçus pour mettre en évidence rapidement les nouvelles histoires : la popularité perd de son efficacité avec le temps. NeedSift a un objectif différent. Un produit utile ne devrait pas disparaître simplement parce qu'il a été lancé il y a des mois, mais il devrait progressivement perdre des points de maintenance si chaque signe public devient obsolète. La fenêtre de maintenance incrémentée donne un bon départ aux nouveaux produits et permet aux produits plus anciens de se rétablir immédiatement en effectuant un travail vérifiable.
Des recherches sur l'abandon de projets open source montrent également pourquoi une seule date de dernière validation n'est pas suffisante pour décrire la survie d'un projet. NeedSift ne prétend pas qu'une seule trace publique prouve la santé d'un produit. Il combine des chemins indépendants et limite délibérément chaque composant. La formule évoluera, mais les changements doivent rester explicables et testables.
Le score est consultable, et non une "boîte noire"
Chaque composant est stocké côté serveur et affiché sur la page du produit dans la section "Pourquoi ce score" ? Les développeurs peuvent consulter la disponibilité, la maintenance, la qualité du site, l'activité sociale, l'exhaustivité et la contribution de la communauté, au lieu de deviner pourquoi un concurrent les a dépassés. Les modifications de l'ordre du catalogue ne sont prises en compte qu'après que le serveur recalcule les scores ; il ne les réorganise pas dans le navigateur pendant que quelqu'un lit.
La transparence ne signifie pas publier tous les seuils anti-abus de manière permanente. Cela signifie publier les règles normales, séparer les faits mesurés des décisions éditoriales, et expliquer les changements importants. L'objectif n'est pas une définition mathématiquement parfaite de la qualité. Il s'agit d'un classement dont les incitations visent à favoriser les produits fiables, une maintenance honnête et un travail public utile.
- Directives de Stanford pour la crédibilité du web
- Sur l'abandon et la survie des projets open source (arXiv:1906.08058)
- Directives de Google pour l'évaluation de la qualité de recherche
- La qualité d'un site web comme indicateur de la qualité d'un produit (MIS Quarterly)
- Discussion sur Hacker News concernant la base de classement publique
Historique des versions
La formule évolue à mesure que NeedSift apprend ce qui distingue les produits entretenus des produits abandonnés. Chaque version indique ce qui a changé et pourquoi. Les scores sont recalculés lors de l’analyse quotidienne suivant la mise en ligne d’un changement.
- v2 — 25 septembre 2026. Le soutien de la communauté combine désormais les votes (jusqu’à 12 points) et la discussion (jusqu’à 3 points) : commentateurs distincts ayant des commentaires approuvés, créateur exclu, avec une réduction pour les comptes récents. Les points complets ne correspondent plus à un nombre fixe de votes : ils se situent au 90e centile du catalogue, avec des planchers de 10 votes et 5 commentateurs, pour que l’échelle grandisse avec NeedSift.
- v1 — 24 septembre 2026. Première formule publique : disponibilité 20, maintenance 25, qualité du site 15, activité sociale 10, complétude 15 et votes 15 sur une courbe logarithmique fixe, V = min(15, 5 × ln(1 + W)), les votes des comptes récents étant pondérés à 0,25.