Dentro del Algoritmo de Clasificación de NeedSift: La Fórmula Detrás de Cada Puntuación
La fórmula exacta de clasificación de NeedSift, pesos de las señales, ventanas de actualización, salvaguardas de votación, comprobaciones de calidad del sitio y la justificación detrás de cada puntuación de producto.
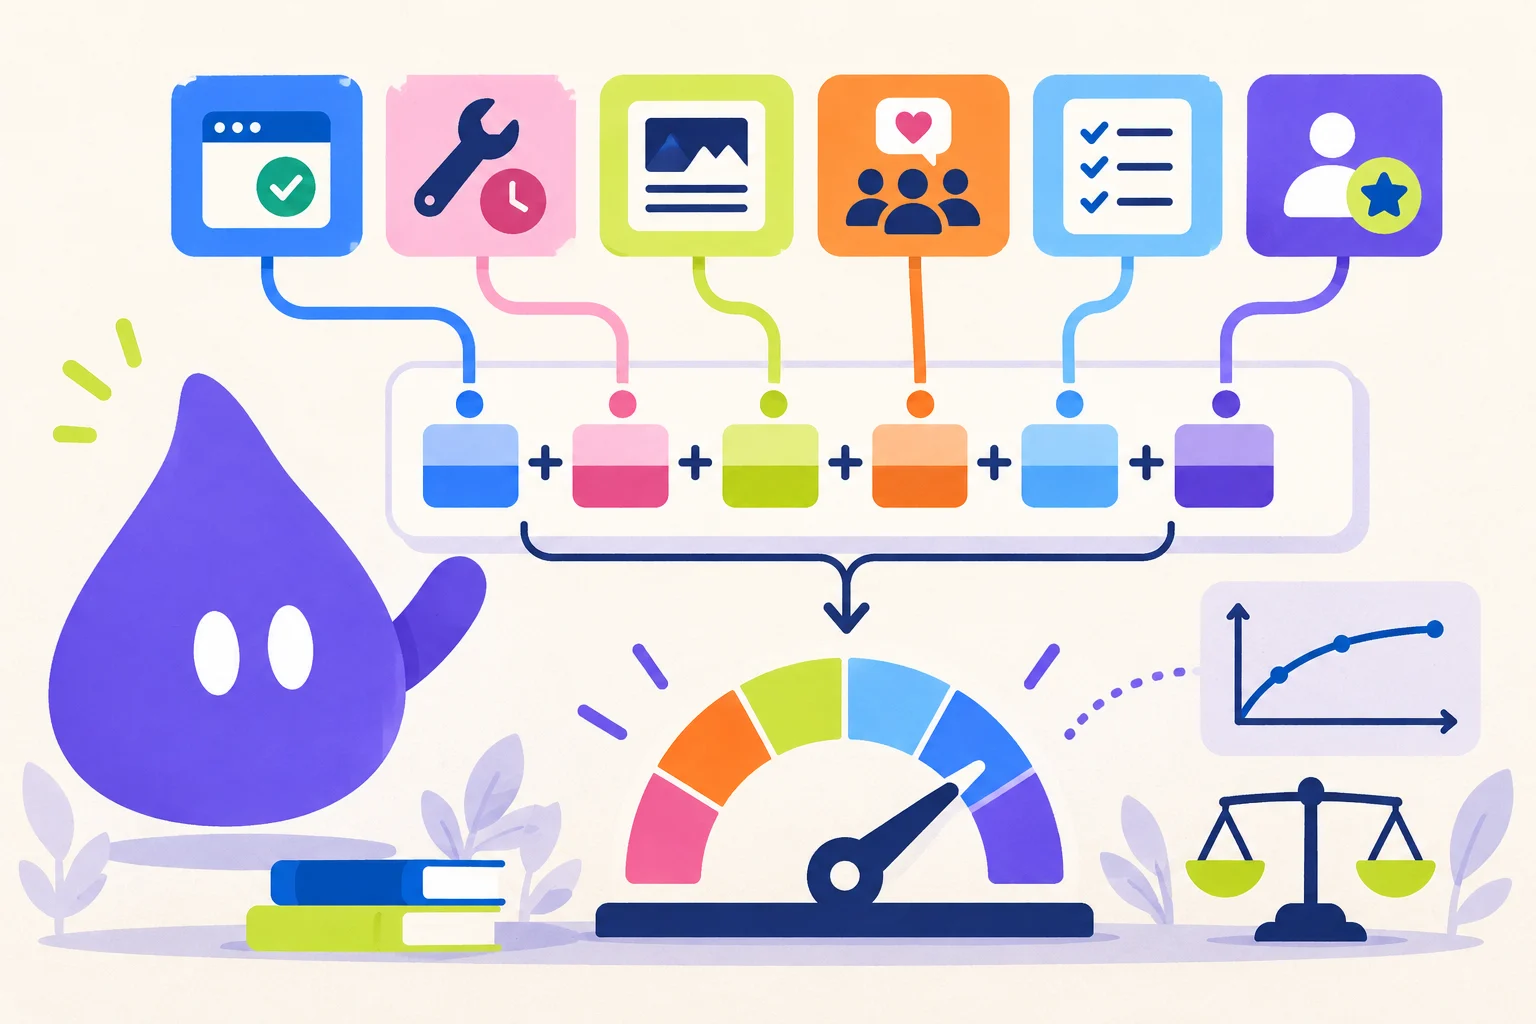
Una puntuación, seis señales independientes
El catálogo de NeedSift no está ordenado por los votos brutos, el número de páginas o la fecha en que se presentó un producto. El backend calcula una puntuación de cero a cien antes de devolver el catálogo. La misma puntuación almacenada se utiliza para cada visitante, por lo que las tarjetas no cambian de orden después de la hidratación.
La fórmula combina la fiabilidad, el mantenimiento reciente, la calidad del sitio web, la actividad pública, la exhaustividad de la lista y el soporte de la comunidad autenticado. Una gran audiencia solo ayuda dentro del componente de la comunidad limitada. Un producto pequeño puede alcanzar la cima permaneciendo disponible, entregando, explicando claramente y manteniendo pruebas públicas creíbles.
Esta página describe la versión 2 de la fórmula, vigente desde el 25 de septiembre de 2026. Cada cambio del algoritmo aparece en el historial de versiones al final del artículo, para que los creadores vean qué cambió y por qué.
Score = min(100, 0.20U + 0.25M + 0.15Q + 0.10S + C + V)U, M, Q y S se normalizan de 0 a 100. C y V contribuyen directamente de 0 a 15 puntos cada uno. El total se redondea a dos decimales y se limita a 100.- Tiempo de actividad: hasta 20 puntos.
- Mantenimiento: hasta 25 puntos.
- Calidad del sitio web: hasta 15 puntos.
- Actividad social: hasta 10 puntos.
- Exhaustividad de la lista: hasta 15 puntos.
- Apoyo de la comunidad V: hasta 15 puntos (12 por votos, 3 por conversación).
El tiempo de actividad recompensa un producto que realmente funciona.
El tiempo de actividad se basa en observaciones diarias del último período de 30 días. El 70% del componente proviene de la proporción de comprobaciones exitosas. El 30% restante proviene del tiempo de respuesta medio de las comprobaciones exitosas, no de la respuesta más rápida.
Una respuesta de 800 milisegundos o menos recibe un bono de velocidad de 30 puntos; de 2 segundos o menos, recibe 22; de 5 segundos o menos, recibe 12; una respuesta exitosa más lenta recibe 4. Un dominio inactivo recibe cero, independientemente de su estado HTTP.
U = min(100, 70 × available_days / observed_days + speed_bonus)speed_bonus = 30 cuando la mediana ≤ 800 ms; 22 cuando ≤ 2.000 ms; 12 cuando ≤ 5.000 ms; de lo contrario, 4.El mantenimiento utiliza la fecha más reciente y verificada.
Un producto no debería tener que reescribir su página de inicio cada semana para que parezca actualizado. NeedSift obtiene la fecha más reciente y confiable de cinco fuentes independientes: un cambio significativo en la página de inicio, el propio registro de cambios o blog del producto, una versión de App Store o Google Play, una URL de sitemap recién publicada, o una actualización pública de GitHub o Telegram.
El primer escaneo crea una línea de base y no pretende que todo lo que ya está presente sea una nueva actualización. Un producto también recibe una ventana de lanzamiento de siete días a partir de su fecha de creación de NeedSift. Después de eso, debe demostrar actividad. Las puntuaciones de subcategorías para Store, sitemap y redes sociales permanecen visibles para la explicación, pero sus fechas más recientes y verificadas fluyen al mantenimiento para que el total no recompense la misma versión varias veces.
M(age) = 100 ≤7d · 85 ≤30d · 60 ≤90d · 35 ≤180d · 10 otherwiseLa edad se mide a partir de la fecha de actividad más reciente y verificada, o, cuando aún no se ha observado ninguna actividad, la fecha de creación del producto.La calidad del sitio mide la confianza, no el tamaño del sitio web.
El analizador de calidad puede dar a un producto indie de una sola página la misma puntuación de 100 que un sitio web grande. Busca metadatos útiles, soporte móvil, un favicon y una señal canónica o de idioma; rutas legales y de contacto; rutas de precios, documentación, descarga o registro; un registro de cambios; suficiente contenido real del producto; y evidencia de que la página realmente describe el producto listado.
Los metadatos contribuyen con hasta 40 puntos de calidad brutos, confianza y estructura del producto 36, identidad 12, y sustancia 12. Una página con menos de cuarenta palabras tiene su resultado reducido a la mitad. Un dominio estacionado o en venta recibe cero. NeedSift verifica un máximo de ocho imágenes de la página de inicio: cuando se muestren al menos tres, las imágenes rotas restan 10, 20 o 30 puntos dependiendo de su proporción. Esto explica por qué una página de producto visualmente rota no puede recibir el crédito completo de calidad simplemente porque sus etiquetas meta son correctas.
Q = clamp₀₋₁₀₀(metadata + trust + identity + substance − image_penalty)La clasificación final recibe el 15% de este resultado de calidad normalizado. El volumen de páginas y el tráfico de marketing no son factores de entrada. Actividad pública y completitud del perfil
Para la actividad pública, cada perfil de GitHub o Telegram accesible añade 15 puntos brutos, con un máximo de 45. Un nuevo post o commit establece la puntuación social en 100. De lo contrario, la actividad dentro de siete, treinta o noventa días añade 55, 40 o 20 puntos. Los enlaces de X no se rastrean sin una interfaz pública fiable. Si un producto no tiene un perfil público rastreable, la puntuación social es neutral en 30 en lugar de convertirse en una penalización.
La completitud es intencionalmente finita. Un logotipo contribuye con 3 puntos. Las capturas de pantalla contribuyen con 1,5 cada una hasta 4. Una descripción contribuye con 2 puntos a partir de 120 caracteres y 4 a partir de 300. Una etiqueta añade 1; la cobertura de enlaces útiles añade hasta 2; una categoría añade 1. Añadir diez enlaces duplicados o cientos de capturas de pantalla no puede aumentar el resultado.
S = min(100, 15 × reachable_profiles + freshness_bonus); S = 30 when untrackedfreshness_bonus = 55 para ≤7 días, 40 para ≤30 días, 20 para ≤90 días; la actividad recién observada hace que S = 100. C = logo(3) + screenshots(max 4) + description(max 4) + tagline(1) + links(max 2) + category(1)La completitud está limitada naturalmente a 15 puntos y recompensa la evidencia útil en lugar del volumen de perfiles.Los votos y la conversación ayudan, pero no compran el catálogo
NeedSift utiliza votos positivos en lugar de una escala de valoración positiva y negativa. Por lo tanto, un intervalo de Wilson es el modelo incorrecto, mientras que un promedio Bayesiano al estilo IMDb requeriría un valor de valoración significativo para acercarse a un catálogo. En cambio, NeedSift utiliza una curva logarítmica: el apoyo genuino inicial es importante, las recompensas disminuyen rápidamente y la influencia de la comunidad se limita a quince puntos.
El techo de la curva no es un número fijo de votos. Los puntos completos por votos están en el percentil 90 de los votos ponderados de todos los productos aprobados, con un mínimo de diez. Dicho de forma sencilla, un producto obtiene los doce puntos de votos cuando tiene más apoyo que nueve de cada diez productos del catálogo. Se usa un percentil en lugar del máximo porque un solo producto inflado puede mover el máximo, pero no el percentil 90. El mínimo evita que un catálogo joven reparta la puntuación completa por un único voto. La escala se recalcula en cada análisis diario.
Para votar, se requiere autenticación y una cuenta solo puede emitir un voto por producto. Si la cuenta tenía menos de veinticuatro horas de antigüedad cuando se emitió el voto, este recibe un peso de 0.25. Una cuenta establecida recibe 1. Esto no resuelve todas las campañas coordinadas, pero hace que las cuentas de lanzamiento desechables sean cuatro veces menos efectivas y crea una base clara para la revisión de anomalías.
W = Σ vote_weight; vote_weight = 0.25 if account_age < 24h, otherwise 1La antigüedad de la cuenta se mide en el momento del voto, por lo que esperar más tarde no mejora retroactivamente un voto sospechosamente reciente.V_votes = 12 × min(1, ln(1 + W) / ln(1 + W₉₀)); W₉₀ = max(10, P90 of W across the catalog)Con la escala mínima, un voto completo vale unos 3,47 puntos, tres unos 6,94 y diez alcanzan el techo de 12 puntos. A medida que crece el catálogo, W₉₀ crece con él y el mismo número de votos vale proporcionalmente menos.V = V_votes + V_discussionLa conversación se describe en la siguiente sección y añade como máximo 3 puntos, así que V nunca supera 15.La conversación cuenta un poco
Los productos de los que la gente habla suelen ser productos que la gente usa. Desde la versión 2, el componente de comunidad también cuenta la conversación bajo un producto. La unidad es la persona, no el mensaje: cada comentarista distinto cuenta una vez, escriba los comentarios que escriba, así que una larga discusión entre dos cuentas no parece una multitud.
Solo cuentan los comentarios que pasaron la moderación. Los comentarios del propio creador del producto no cuentan: responder preguntas es bienvenido, pero no debe subir su propia puntuación. Un comentarista cuya cuenta tenía menos de veinticuatro horas en su primer comentario cuenta como 0,25, el mismo descuento que los votos de cuentas nuevas. Los comentarios ocultos, rechazados y eliminados cuentan como cero.
El peso es deliberadamente pequeño. Las cuentas son baratas y el texto de un comentario es fácil de generar, así que la conversación sirve para desempatar productos parecidos, no como palanca. Usa la misma escala relativa al catálogo que los votos, con un mínimo de cinco comentaristas.
D = Σ commenter_weight; commenter_weight = 0.25 if account_age < 24h at first comment, otherwise 1Una entrada por cada comentarista distinto con al menos un comentario aprobado, sin contar al creador.V_discussion = 3 × min(1, ln(1 + D) / ln(1 + D₉₀)); D₉₀ = max(5, P90 of D across the catalog)Con la escala mínima, un comentarista establecido vale unos 1,16 puntos, tres unos 2,32 y cinco alcanzan el techo de 3 puntos.Un ejemplo práctico.
Considere un producto con una disponibilidad perfecta, actividad en los últimos treinta días, un resultado de calidad del sitio de 80, una puntuación social de 70, trece puntos de completitud y tres votos establecidos. El producto obtiene 20 puntos de disponibilidad, 21,25 puntos de mantenimiento, 12 puntos de calidad, 7 puntos sociales, 13 puntos de completitud y 6,94 puntos de la comunidad.
Su puntuación final es de 80,19. Más votos aún pueden ayudar, pero incluso suficientes votos para alcanzar el límite solo añadirían 8,06 puntos más. La opción más sólida es mejorar la evidencia del producto: reparar los medios, mantener el sitio disponible, publicar una versión real, completar la lista o añadir un changelog útil.
20 + 21.25 + 12 + 7 + 13 + 6.94 = 80.19Ejemplos de entradas: U=100, M=85, Q=80, S=70, C=13, W=3, D=0, W₉₀=10. ¿Por qué esto es diferente de las listas de lanzamiento?
Las listas de "tiempo de decadencia", como Hacker News, están diseñadas para mostrar historias nuevas rápidamente: la popularidad pierde poder a medida que la publicación envejece. NeedSift tiene un objetivo diferente. Un producto útil no debería desaparecer simplemente porque se lanzó hace meses, pero debería perder gradualmente puntos de mantenimiento si cada señal pública se vuelve obsoleta. La ventana de mantenimiento escalonada da a los nuevos productos un buen comienzo y permite que los productos más antiguos se recuperen inmediatamente enviando trabajo verificable.
La investigación sobre el abandono de proyectos de código abierto también muestra por qué una única fecha de última confirmación no es suficiente para describir la supervivencia del proyecto. NeedSift no afirma que cualquier rastro público demuestre la salud del producto. Combina caminos independientes y limita deliberadamente cada componente. La fórmula evolucionará, pero los cambios deben seguir siendo explicables y comprobables.
La puntuación es visible, no es una caja negra
Cada componente se almacena en el backend y se muestra en la página del producto en la sección "Por qué esta puntuación". Los usuarios pueden ver el tiempo de actividad, el mantenimiento, la calidad del sitio, la actividad social, la exhaustividad y la contribución de la comunidad, en lugar de adivinar por qué un competidor los superó. Los cambios en el orden del catálogo solo se aplican después de que el backend recalcule las puntuaciones; no se reorganizan en el navegador mientras alguien está leyendo.
La transparencia no significa publicar todos los umbrales anti-abuso de forma permanente. Significa publicar las reglas normales, separar los hechos medidos de las decisiones editoriales y explicar los cambios materiales. El objetivo no es una definición matemáticamente perfecta de la calidad. Es un ranking cuyo incentivo apunta a productos fiables, mantenimiento honesto y trabajo público útil.
- Directrices de Stanford para la credibilidad de la web
- Sobre el abandono y la supervivencia de proyectos de código abierto (arXiv:1906.08058)
- Directrices de Google para la evaluación de la calidad de búsqueda
- La calidad del sitio web como señal de la calidad del producto (MIS Quarterly)
- Discusión en Hacker News sobre la línea de base de clasificación pública
Historial de versiones
La fórmula cambia a medida que NeedSift aprende qué distingue a los productos mantenidos de los abandonados. Cada versión indica qué cambió y por qué. Las puntuaciones se recalculan en el siguiente análisis diario tras publicar un cambio.
- v2 — 25 de septiembre de 2026. El apoyo de la comunidad combina ahora votos (hasta 12 puntos) y conversación (hasta 3 puntos): comentaristas distintos con comentarios aprobados, sin el creador, con descuento para cuentas nuevas. La puntuación completa ya no es un número fijo de votos: está en el percentil 90 del catálogo, con mínimos de 10 votos y 5 comentaristas, de modo que la escala crece junto con NeedSift.
- v1 — 24 de septiembre de 2026. Primera fórmula pública: disponibilidad 20, mantenimiento 25, calidad del sitio 15, actividad social 10, completitud 15 y votos 15 en una curva logarítmica fija, V = min(15, 5 × ln(1 + W)), con los votos de cuentas nuevas ponderados a 0,25.